NLP・NLU・NLGの違いとは?AIが文章を理解・生成する仕組みを専門家目線で解説
AIが人間の言語を理解し、自然な会話を行う仕組みの中心には「自然言語処理(NLP: Natural Language Processing)」という技術があります。近年では、ChatGPTのような高度なAIの登場により、文章生成能力が飛躍的に向上し、人間と区別がほとんどつかない自然な対話が可能となっています。
しかしながら、「NLP」「NLU(自然言語理解)」「NLG(自然言語生成)」という用語はしばしば混同されることが多く、それぞれの正確な意味や役割を理解している人は必ずしも多くありません。
本記事では、これら3つの概念を体系的に整理し、AIがどのように人間の言葉を解析し、意味を理解し、応答として文章を生成しているのかをわかりやすく解説します。また、各技術の役割と連携の仕組みを理解することで、AIによる会話や文章生成の背景にある仕組みをより深く把握することができます。
1. 自然言語処理(NLP)の概要
自然言語処理(NLP: Natural Language Processing)は、人間の言葉をコンピュータが理解・解析・生成するAI技術です。テキストや音声から意味を抽出し、翻訳、音声認識、検索補完などに応用されています。
NLPは主に以下の2つに分かれます。
- 自然言語理解(NLU):文脈や意味を理解する技術
- 自然言語生成(NLG):自然な文章を生成する技術
代表的な技術と応用例:
技術 | 応用例 |
| 形態素解析 | 単語分割・品詞解析(例:日本語の分かち書き) |
| 構文解析 | 文構造の理解(例:主語・述語の関係) |
| 意味解析 | 単語や文脈の意味推定 |
| 感情分析 | SNS投稿・レビューの感情判定 |
| チャットボット | 顧客対応の自動化 |
これらの技術進化により、より自然で高精度なAI対話や情報処理が実現しつつあります。
自然言語処理(NLP)の仕組み
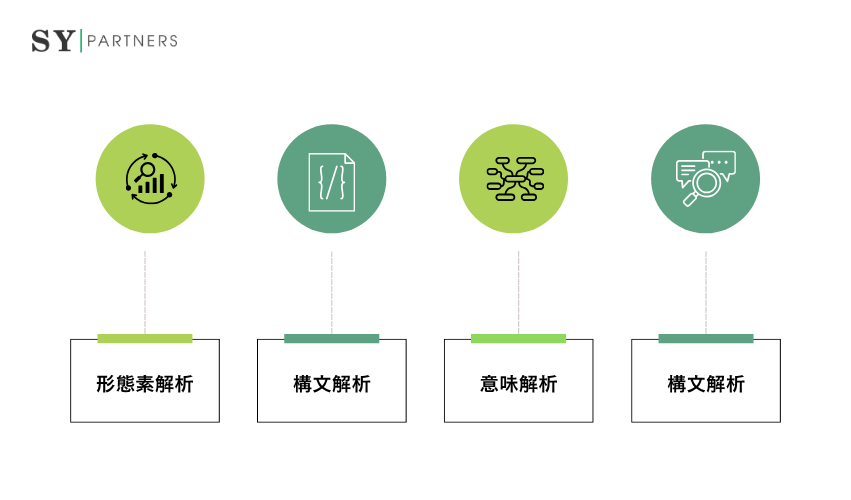
自然言語処理は主に「①形態素解析」「②構文解析」「③意味解析」「④文脈解析」の4段階で構成されています。以下では、それぞれの解析について説明します。
① 形態素解析
文章を最小単位(形態素)に分割し、各単語に品詞などの情報を付与します。これにより、AIは語彙の役割や関係性を学習し、自然な文章生成や理解の基礎を形成します。
② 構文解析
形態素解析で得た単語間のつながりを分析し、文の構造を構築します。代表的な手法として「依存構造解析」や「句構造解析」があり、日本語では主に前者が用いられます。
③ 意味解析
構文解析によって得られた複数の解釈の中から、文として最も自然で正確な意味を特定します。AIが「文の意味を理解する」段階といえる工程です。
④ 文脈解析
文章全体の流れを把握するため、複数の文の関係性を解析します。文脈を正確に理解するには高度な知識や推論が必要であり、近年では機械学習やニューラルネットワークによる精度向上が進められています。
2. 自然言語理解(NLU)の概要
自然言語理解(NLU: Natural Language Understanding)は、自然言語処理(NLP)の一分野で、人間の言語をコンピュータが「理解」し、意味や意図を抽出する技術です。NLPが言語データ全体の処理を扱うのに対し、NLUは特に文脈把握や意図認識に焦点を当てます。
主な要素は以下の3つです。
- 意図認識:ユーザーの目的を特定(例:「ピザを注文したい」→注文意図)。
- エンティティ抽出:テキストから固有情報を抽出(例:「午後2時の予約」→時間と予定)。
- 文脈理解:会話履歴や背景を踏まえた応答生成。
NLUは、音声アシスタント(Siri・Alexa)、チャットボット、感情分析、自動翻訳などに活用され、より自然な対話と顧客体験の向上を実現しています。
NLUの仕組みと主要技術
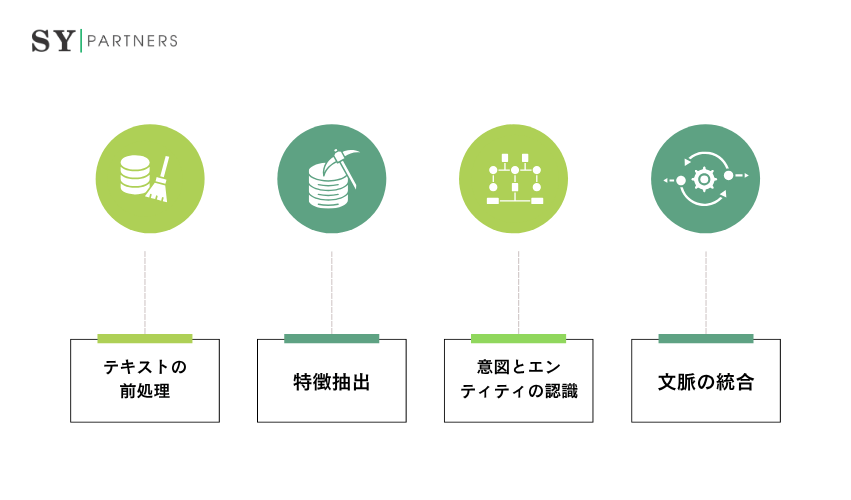
NLU(自然言語理解)は、人間の言語を機械が理解できる形に変換するプロセスで、複数のステップと技術で構成されています。
① テキストの前処理
まず、入力データ(テキストや音声)を機械が扱いやすい形に整えます。
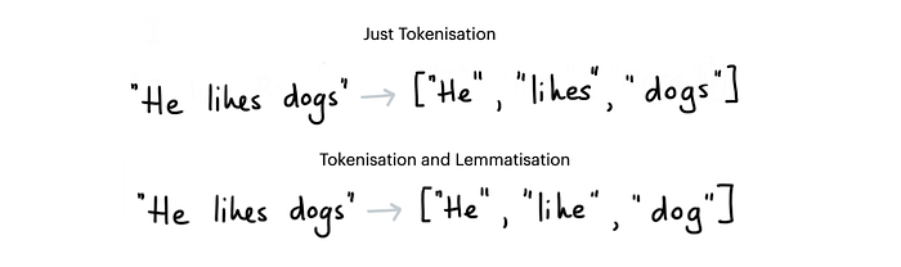
- トークン化(Tokenization):文を単語やフレーズに分割。日本語では形態素解析を使用。
- 正規化(Normalization):大文字・小文字や記号の統一、ノイズ除去。
- ストップワード除去:意味に影響しない単語(例:「は」「の」)を削除。
② 特徴抽出
次に、言語の意味を捉えるための特徴を数値化します。
- ワードエンベディング(Word Embeddings):単語を意味的なベクトルに変換(例:Word2Vec、BERT)。
- 構文解析(Syntactic Analysis):文の文法構造を分析し、主語・述語の関係を特定。
- 意味解析(Semantic Analysis):文脈に基づいて単語の意味を理解。
③ 意図とエンティティの認識
ユーザーの目的(意図)と具体的な情報(エンティティ)を特定。
例:「東京で明日の天気を教えて」→意図:「天気予報の取得」、エンティティ:「東京」「明日」。
この処理には、機械学習やトランスフォーマーモデル(例:BERT)が用いられ、データからパターンを学習します。
④ 文脈の統合
会話履歴や外部情報を踏まえて意味を補完します。
例:「次は大阪の天気」→「天気予報」という意図を継続し、「大阪」を新しいエンティティとして認識。
これにより、連続性のある自然な対話が実現します。
3. 自然言語生成(NLG)の概要
自然言語生成(NLG: Natural Language Generation)は、自然言語処理(NLP)の一分野で、構造化データ(例:数値・表)や非構造化データ(例:テキスト・音声)を、人間が理解しやすい自然な文章や音声に変換する技術です。
たとえば、気象データから「明日の東京は晴れ、最高気温25℃」といった文章を生成したり、顧客対応で「ご注文の商品は明日発送予定です」と自動応答したりできます。
NLGは、自然言語理解(NLU)と組み合わせることで、より自然で文脈に沿った対話を実現します。NLUが「理解」を担い、NLGが「表現」を担うことで、チャットボット、音声アシスタント、自動レポート作成など、多様なビジネスシーンで活用されています。
NLGの仕組みと主要技術
自然言語生成(NLG)は、データを自然で人間らしい言語に変換するための多段階プロセスです。以下では、代表的な手順と主要技術を整理します。
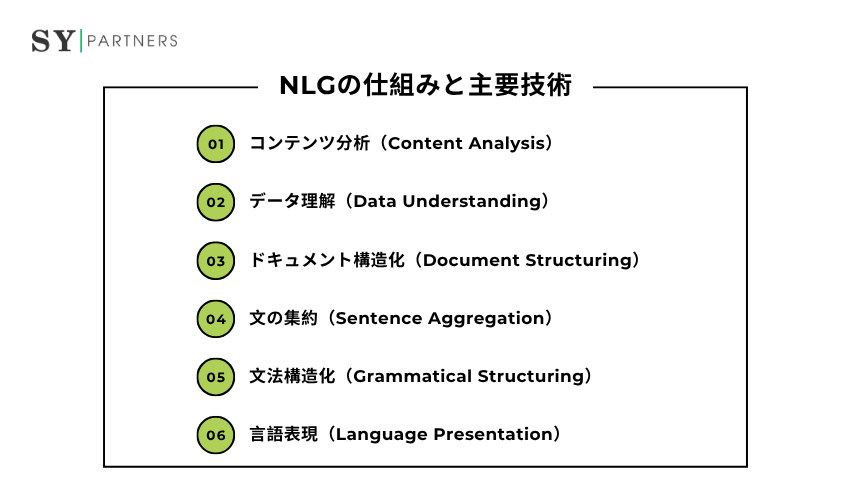
① コンテンツ分析(Content Analysis)
最初の段階では、入力データを分析し、生成に必要な情報を抽出します。
例:売上データから「前年比10%増」といった要点を選定。
② データ理解(Data Understanding)
抽出した情報の意味や傾向を理解し、それがどのような背景や文脈に基づくのかを分析します。
この際、機械学習(例:トランスフォーマー)やルールベースの手法を用いて、データ間の関連性を把握します。
例:顧客レビューから「満足度が高い」という洞察を抽出。
③ ドキュメント構造化(Document Structuring)
出力文書の構成や順序を設計します。
例:財務レポートなら「概要 → 売上分析 → 今後の予測」という流れを設定。
④ 文の集約(Sentence Aggregation)
関連情報を統合し、冗長性を減らして自然な文を生成します。
例:「売上が10%増」「利益率が向上」→「売上が10%増加し、利益率も向上した」。
⑤ 文法構造化(Grammatical Structuring)
文法ルールや意味構造を適用し、自然で分かりやすい文章を組み立てます。
語彙の選択や文の流れを整え、読み手にとって自然に感じられる表現へと仕上げます。
⑥ 言語表現(Language Presentation)
最終的な出力は、レポート・メール・音声など、指定されたフォーマットに整形します。
また、目的や読者に合わせて文体やトーンを調整します。
例:ビジネス用途→フォーマル、一般ユーザー向け→カジュアル。
主要技術
- テンプレートベースNLG:定型文テンプレートにデータを挿入。簡易で精度が高いが柔軟性に欠ける。
- 統計的NLG:確率モデル(例:隠れマルコフモデル)に基づき文章を生成。
- ニューラルNLG:深層学習(例:トランスフォーマー、GPTシリーズ)により文脈に即した自然な文章を生成。現在の主流。
- 強化学習:ユーザー反応などを報酬として学習し、対話や創造的コンテンツを最適化。
4. NLP・NLU・NLGの違い
AIにおける自然言語技術は、大きくNLP・NLU・NLGの3つに分類されます。それぞれの役割や処理内容を理解することで、AIがどのように人間の言葉を「読み」「理解し」「表現する」のかが明確になります。
項目 | NLP(自然言語処理) | NLU(自然言語理解) | NLG(自然言語生成) |
| 目的 | 言語データを構造化し、機械が処理できる形にする | テキストの意味や意図を理解する | 理解した情報を自然な言葉で表現する |
| 役割 | 「読む」 | 「理解する」 | 「話す」 |
| 主な処理内容 | トークン化、構文解析、形態素解析、固有表現認識 | 意味解析、感情分析、文脈理解、意図分類 | 文書構成、文生成、要約、スタイル調整 |
| 入力データ | 生テキスト(単語・文・文法) | NLPで処理された構造化データ | NLUで理解された意味データや意図モデル |
| 出力データ | 構文情報・タグ付け・言語構造 | 意図モデル・感情ラベル・意味マップ | 自然文・会話文・レポートなど |
| 特徴 | 文法・構造中心の分析 | 意味・文脈中心の解釈 | 表現・文章化中心の生成 |
| 代表的な用途 | 検索エンジン、翻訳、音声認識 | チャットボット、QAシステム、感情分析 | ChatGPT、レポート生成、記事自動作成 |
| 依存関係 | NLUとNLGの基盤となる | NLPの結果を理解に利用 | NLUの理解結果をもとに出力を生成 |
| 成果 | 構造化されたテキストデータ | 意図を理解したデータモデル | 人間に伝わる自然な文章 |
NLP・NLU・NLGはそれぞれ独立した技術ですが、連携することでAIは文脈を踏まえた自然で正確な対話を実現します。 NLPで言語を構造化し、NLUで意味を理解し、NLGで文章として表現するという3つのプロセスの連動が、現代AIの言語理解の基盤となっています。
5. NLP・NLU・NLGの関係
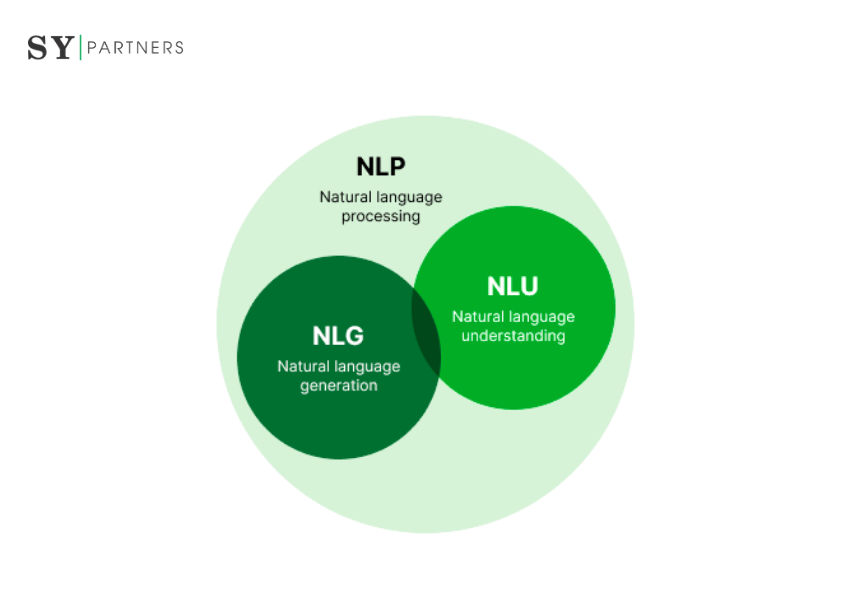
自然言語処理(NLP:Natural Language Processing)は、人間の言語をコンピュータが理解し、やり取りできるようにする人工知能(AI)の一分野です。トークナイズ、レンマ化、構文解析、意味解析、機械翻訳などの多様な技術を用いて、非構造的なテキストデータから意味を抽出し、人間と機械の自然で双方向的なコミュニケーションを実現します。
現代のNLPシステムは、NLP・NLU(自然言語理解)・NLG(自然言語生成)という3つの主要な自然言語技術によって支えられています。NLPが言語データを処理する基盤を提供し、NLUがその意味や意図、文脈を理解し、NLGが理解した情報を自然で人間らしい表現として生成します。
これらの技術を組み合わせることで、会話型AIやバーチャルアシスタント、チャットボットなどが文脈を踏まえた自然で流暢な対話を行うことが可能になっています。
6. NLP・NLU・NLGの限界と課題
AIの自然言語技術は日々進化していますが、現状では技術面・言語面・運用面でさまざまな限界が存在します。
ここでは、NLP・NLU・NLGそれぞれの課題を整理し、導入や運用における注意点を明らかにします。
6.1 NLPの限界と課題
自然言語処理(NLP)は、人間の言語を理解・分析・活用するための中核技術として発展していますが、現段階ではまだ多くの課題が残されています。以下では、技術面・言語面・運用面の主な限界を整理します。
6.1.1 文脈理解の難しさ
NLPは単語や文法を分析できても、文脈や意図を正確に読み取るのは難しい場合があります。皮肉や比喩、感情の微妙なニュアンスなど、言葉の裏にある意味を誤解するリスクが依然として高いです。
6.1.2 多言語・文化差への対応
多くのNLPモデルは英語中心で設計されており、他言語や異文化的表現への対応は限定的です。語順・文法構造・慣用表現の違いにより、翻訳や解析精度が低下することがあります。
6.1.3 データバイアス
NLPは学習データに依存するため、データが偏っていると出力にもバイアスが反映されます。ジェンダー・人種・地域などに関する偏見を助長する恐れがあり、倫理的な管理が求められます。
6.1.4 専門分野・長文解析の限界
医療・法律・金融などの専門分野では、専門用語や複雑な構造を正確に扱うのが難しく、誤解析や情報の欠落が起こることがあります。長文や複雑な議論構造を処理する際にも限界があります。
6.1.5 リソースとコスト
高性能なNLPモデルには大量のデータ・計算資源・専門知識が必要です。そのため、開発・運用コストが高く、中小規模の組織では導入ハードルとなることがあります。
6.2 NLUの限界と課題
自然言語理解(NLU)は、AIが人間の言葉の「意味」を正しく理解するための中核技術ですが、文脈の多様性や人間的な曖昧さの処理にはまだ多くの課題があります。ここでは、NLUを活用する際に注意すべき主な限界を整理します。
6.2.1 曖昧な表現の解釈
人間の言語には多義語や省略、比喩などが多く含まれます。NLUは文脈を分析して意味を推定しますが、状況や背景知識が不足している場合、誤った解釈を行うことがあります。
6.2.2 感情・意図の理解の難しさ
NLUは感情や話者の意図を数値的に扱うため、微妙なニュアンスや皮肉、遠回しな表現を正確に捉えることが難しいです。その結果、ユーザーとの対話で不自然な応答が生じる場合があります。
6.2.3 知識と常識の不足
多くのNLUモデルは大量のテキストを学習しているものの、人間のような「常識」や「背景知識」を理解しているわけではありません。そのため、論理的には正しくても実際には不自然な解釈をすることがあります。
6.2.4 分野・文化ごとの理解精度
NLUの性能は学習データの種類に大きく依存します。特定分野(例:医療・法律・教育)や文化的背景が異なるデータに対しては、理解精度が低下しやすく、誤った判断につながる恐れがあります。
6.2.5 モデルの透明性と説明可能性
深層学習を用いたNLUモデルは「なぜその解釈をしたのか」を説明しにくいという問題があります。このブラックボックス性は、信頼性や倫理面での課題として指摘されています。
6.3 NLGの限界と課題
自然言語生成(NLG)は、文章作成や情報発信を効率化する革新的な技術ですが、まだ多くの課題を抱えています。ここでは、導入や運用の際に注意すべき主要なポイントを整理します。
6.3.1 言語特性への対応
NLGは英語を中心に発展してきたため、多言語環境では表現の自然さや文化的ニュアンスを再現しきれないことがあります。敬語や語順、文体の差異を的確に扱うためには、言語ごとの最適化が必要です。
6.3.2 創造性と感情表現の限界
データやルールに基づく生成は得意ですが、創造性や感情を伴う表現には弱点があります。物語、ユーモア、広告コピーなど、人間特有の感性が求められる領域では、AIだけでは不十分なケースが多いです。
6.3.3 データ品質への依存
NLGの性能は、学習に使うデータの量と質に左右されます。偏りや誤りを含むデータを使うと、生成結果にも影響が出ます。正確で多様なデータセットの整備が信頼性向上の鍵です。
6.3.4 倫理的・社会的リスク
AIが生成する文章には、誤情報、バイアス、著作権侵害などのリスクがあります。特に医療・法律・報道などの分野では、人間による内容確認と倫理的ガイドラインの整備が不可欠です。
6.3.5 コストと運用負担
高機能なNLGシステムは、導入コスト・維持費・チューニング作業が高額・高難度になりがちです。社内リソースに応じて、小規模導入から段階的に拡張する戦略が現実的です。
NLP・NLU・NLGはいずれも自然言語処理の中核技術であり、多くの可能性を秘めています。
しかし、文脈理解の難しさ、文化・分野差への対応、データバイアス、倫理面の課題など、導入や運用時には注意が必要です。技術の限界を正しく理解し、適切な補助策や運用ルールを設けることが、信頼性の高いAI活用の鍵となります。
おわりに
NLP(自然言語処理)、NLU(自然言語理解)、NLG(自然言語生成)は、AIが人間の言語を正確に扱うための三本柱です。NLPは言語データを構造化・解析する基盤を提供し、NLUは文脈や意味を理解して情報の意図を把握し、NLGは理解した内容を自然かつ適切な形で表現します。この3つの技術が緊密に連携することで、AIは単なる定型的な応答に留まらず、人間らしい会話や高度な文章生成を可能にしています。
これらの技術はすでに私たちの日常生活やビジネス環境に広く浸透しており、検索エンジン、チャットボット、翻訳アプリ、AIライティングなどの基盤として活用されています。AIが「理解し、判断し、表現する」背後には、この三層の技術が常に連携し、情報処理の高度化を支えているのです。