AIエージェント開発会社の選び方|RAG・権限管理・ハルシネーション対策
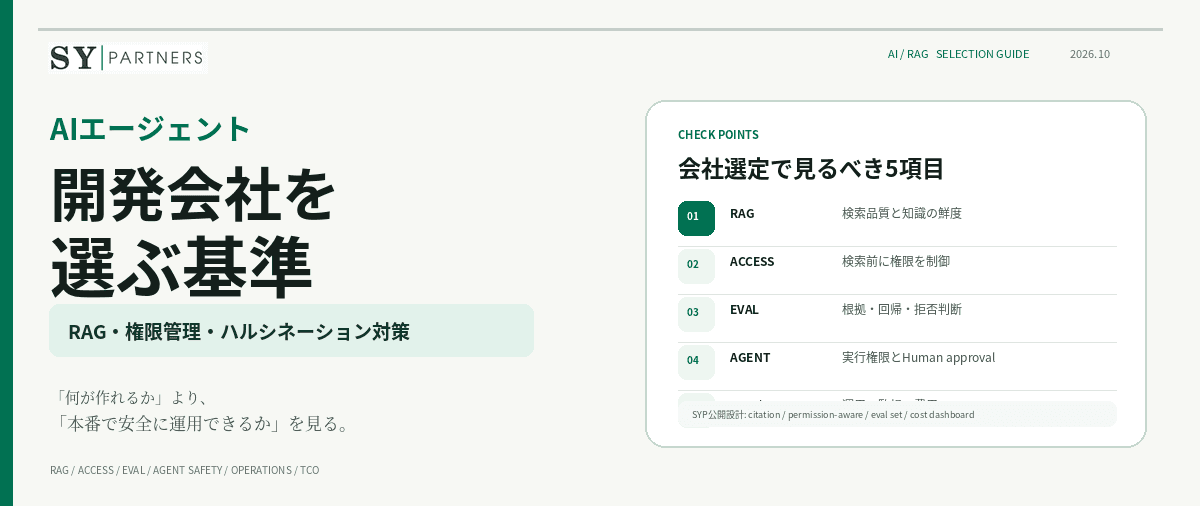
AIエージェント開発会社を選ぶとき、モデル名や「RAG対応」の有無だけで比較すると、本番導入で必要な差を見落とします。社内生成AIでは、正しい文書を検索できるか、利用者の権限外データをAIへ渡さないか、根拠のない回答をどのように検知するか、AIが実行してよい操作をどこまで制限するか、品質を継続的に測定できるかまで設計しなければ、PoCでは動いても日常業務へ定着しません。
そのため本記事では、開発会社そのものを順位付けするのではなく、提案書・RFP・商談で比較すべき評価基準を整理します。RAG、権限管理、ハルシネーション対策、評価設計、知識更新、セキュリティ、Human-in-the-loop、システム連携、運用費、導入後の改善まで、企業向けAIエージェントを「安全に使い続けられる仕組み」として判断するための基準です。
選定基準は、NISTの生成AIリスク管理、OWASPのLLMアプリケーションに関する代表的なリスク、MicrosoftのRAG評価指標、OpenAIの評価設計の考え方も参照しながら整理します。そのうえで、SY Partners(以下SYP)が公開している7層のRAG・複数エージェント構成を、特定ベンダーを推すためではなく「提案書でここまで確認できると判断しやすい」という具体例として使います。
1. 最初の選定基準は「AIで何を作るか」ではなく「どの業務判断を支援するか」
AIエージェント開発会社を選ぶ前に、最初に整理したいのは技術ではなく業務の責任範囲です。AIが読むだけなのか、提案するのか、外部システムへ書き込むのかによって、必要なRAG、権限、Human-in-the-loop、監査の深さが変わります。
1.1 チャットボット、RAG、AIエージェントを同じものとして提案する会社は注意する
社内文書へ質問して回答するだけなら、必要なのは主に検索・根拠表示・権限管理です。一方、会議議事録を作る、案件状況を要約する、設計書をレビューする、チケットを登録する、業務システムへ書き戻すといった用途では、AIが扱う入力・出力・外部操作が増えます。同じ「AIエージェント」という名前でも、失敗時の影響と必要な安全策は大きく異なります。
開発会社を比較するときは、最初に「何を自動化できるか」を聞くのではなく、「この業務でAIが誤った場合に何が起きるか」「最終判断は誰が持つか」「AIは読むだけか、操作まで行うか」を確認します。業務の責任境界を先に整理できる会社ほど、PoCで派手なデモを作るより、本番で安全に使える範囲を現実的に提案しやすくなります。
実務では、提案書に「チャットボット」「RAG」「AIエージェント」という名称が並んでいても、利用者が何を入力し、どのデータへアクセスし、AIが何を返し、どこまで外部システムを操作するのかを一枚の業務フローへ落としてもらうと違いが見えます。例えば、就業規則を検索して回答する用途と、回答内容をもとに人事システムへ申請を登録する用途では、必要な権限・監査・承認の設計がまったく異なります。名称ではなく、入力から最終アクションまでの責任範囲で比較してください。
1.2 ユースケースごとに、必要なRAG・Agent・Human approvalの深さを変える
社内FAQのように回答だけを返す用途では、根拠となる文書、出典、権限、回答を控える条件が中心になります。契約レビューや設計レビューでは、完全性・矛盾・リスクを指摘する評価軸が追加されます。さらに、AIが承認、登録、更新などの操作を行う場合は、操作権限、確認画面、二重実行防止、失敗時の復旧、監査ログまで必要です。
OWASPはLLMアプリケーションの主要リスクとして、Prompt Injection、Sensitive Information Disclosure、Excessive Agencyなどを挙げています。つまり、AIにできることを増やすほど価値が上がる一方、与える権限と安全策も設計しなければなりません。『Agentなら自動で何でもできます』という説明より、どこで人の承認を残すかを具体的に説明できる会社の方が、企業導入では判断しやすくなります。
具体的には、低リスクの社内検索では「根拠表示と権限」が中心になり、契約書レビューでは「見落とし・矛盾・判断根拠」の評価が必要になります。さらに、CRM更新やメール送信まで行うAgentでは、操作前preview、承認者、再実行防止、失敗時rollbackまで確認対象になります。この段階分けを提案側から説明できるかを見ると、単なる生成AI実装会社と業務設計まで考えられる会社を分けやすくなります。
1.3 RFPでは、成功条件を「導入できた」ではなく業務指標で書く
開発会社へ相談する前に、現在の業務時間と失敗コストを整理します。たとえば、営業資料を探す時間を1人1日15分減らしたい、問い合わせの一次回答時間を半分にしたい、設計レビューで見落としを減らしたいといった形です。これがないと、PoCが『回答できた』『画面が動いた』だけで終わり、本番投資の根拠が残りません。
評価指標は回答精度だけでなく、再質問率、出典確認率、利用率、削減時間、人手レビュー時間、1回答あたり費用まで含めます。SYPが公開するAIエージェント開発でも、最初のpilotからevaluation set、有用性評価、cost dashboardを持たせる方針が示されています。選定では、このように価値と品質を最初から測れる構成かを確認します。
RFPには、例えば「問い合わせ一次回答時間を30%削減」「回答の80%以上で参照元を確認可能」「高リスク操作は100%人の承認を通す」といった、業務・品質・安全の3種類のKPIを分けて記載すると比較しやすくなります。モデルの精度だけをKPIにすると、利用されない、確認作業が増える、費用が膨らむといった導入失敗を見落とすため、導入後に現場の仕事がどう変わるかまで成功条件へ含めることが重要です。
2. RAGは「ベクトルDBを使うか」ではなく検索品質と知識管理で比較する
RAGの品質は、モデル性能よりも「必要な情報を正しく見つけ、最新の根拠だけを渡せるか」で大きく変わります。ベクトルDBを使っているという説明だけではなく、検索方法、metadata、版管理、出典まで一つの仕組みとして確認する必要があります。
2.1 検索方式はSemanticだけでなく、文書の種類に合わせて複合設計できるか
RAGの品質は、LLMへ渡す前にどの文書を取得できるかで大きく決まります。意味検索だけでは、製品コード、契約番号、規程名、エラーコードのような完全一致が重要な情報を取りこぼす場合があります。逆にキーワード検索だけでは、利用者が別の言い方で質問したときに関連文書へ届きにくくなります。
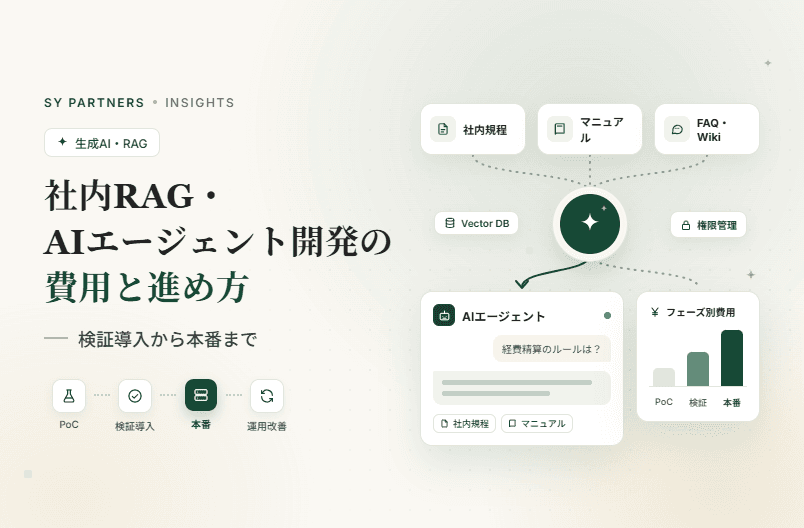
そのため、提案ではEmbeddingモデル名だけを見るのではなく、semantic searchとkeyword searchの組み合わせ、metadata filter、reranking、chunk設計、表や図の取り込み、更新差分の扱いまで確認します。SYPの公開設計ではhybrid semantic + keyword searchを採用し、より良いretrievalでpromptを小さくすることで、精度と運用費を同時に改善する考え方を示しています。
確認時には、検索方式そのものだけでなく、どの文書タイプへどの方式を使うかまで聞きます。規程や長文ナレッジではsemantic searchが有効でも、製品番号や契約IDはkeyword exact matchが重要です。表データやFAQではchunkの切り方も異なります。すべての文書へ同じchunk sizeと同じretrievalを当てる提案より、データ特性ごとに検索戦略を変え、evaluationで妥当性を確認する提案の方が本番運用に向いています。
2.2 RAGの精度は「文書数」より、最新版・有効期限・承認状態を管理できるかで変わる
社内RAGで危険なのは、AIが嘘を作る場合だけではありません。古い規程、廃止された手順、重複した資料を正確に検索して回答することも実務上は問題です。検索技術が高くても、知識そのものの状態が悪ければ、もっともらしい誤回答を安定して生成してしまいます。
開発会社には、文書取り込み後のversion、owner、sensitivity、applicable role、confidence、有効期限をどう持つか、誰が追加・承認・無効化するかを確認します。SYPはvector storeだけでなく原文書とmetadataを保持し、ingest-and-approve、versioning、古い資料のwithdrawalを公開設計に含めています。企業RAGでは、検索より知識運用の設計を説明できるかが重要です。
特に社内文書では、「新しい版があるのに旧版も検索対象に残る」「draftと承認済み資料を区別できない」「担当部署が変わってもowner情報が古い」といった運用上の問題が精度へ直結します。そのため、文書のversion、status、owner、effective date、expiry、sensitivityをmetadataとして管理し、検索対象へ入れる条件を明示できるかを確認してください。RAG精度を高める作業の一部は、検索アルゴリズムではなく情報管理そのものです。
2.3 出典は表示するだけでなく、ユーザーが原文へ戻って確認できる設計にする
出典表示はハルシネーション対策として重要ですが、URLや文書名を付けるだけでは不十分です。利用者が原文へ戻り、該当箇所を確認し、情報が最新か判断できる必要があります。さらに、引用された文書が本人の権限で閲覧できるかも一貫していなければなりません。
開発会社を比較するときは、『回答に引用を付けられますか』ではなく、『どのretrieved chunkを根拠に使ったか追跡できますか』『原文へのリンクを返せますか』『引用先の権限が変わったらどうなりますか』まで確認します。根拠を辿れる設計は、正確性だけでなく監査と利用者の信頼にもつながります。
引用機能の品質を見るときは、回答の末尾に文書名が表示されるだけで満足せず、引用箇所と回答文の対応が分かるかを確認します。ユーザーがクリックして原文の該当箇所へ戻れる、同じ権限で原文を閲覧できる、文書更新後も古いcitationが残らない、といった状態まで設計されていれば、利用者はAI回答を鵜呑みにせず自分で検証できます。これは法務・人事・品質管理のような根拠確認が必要な業務ほど重要です。
3. 権限管理はAI画面で隠すのではなく、検索前に除外できるかを見る
社内生成AIでは、回答の精度と同じくらい権限設計が重要です。権限外の情報をモデルへ渡した後で隠すのではなく、検索段階で候補から除外できるかを確認すると、提案の成熟度が見えやすくなります。
3.1 部署・役職・プロジェクト・顧客単位の権限をretrievalへ引き継げるか
企業の知識は、全社員が同じ範囲を見られるわけではありません。人事、法務、営業、顧客案件、役員資料など、同じデータ基盤に存在していても閲覧条件は異なります。AIの回答画面で特定の文字列を隠すだけでは、権限外の文書がモデルへ渡った時点で安全とは言えません。
選定時には、ユーザー認証後にrole、level、project、clientなどの属性を取得し、検索段階で候補文書をfilterできるか確認します。SYPは権限外データを回答生成前のdata layerで除外し、project・client・sensitivity単位で知識へtagを付ける構成を公開しています。この設計粒度は、権限要件が複雑な社内RAGほど重要になります。
実装確認では、「認証後にroleを取得します」だけでは足りません。検索クエリを作る時点でdepartment、project、client、document sensitivityなどをfilter条件へ変換し、権限外chunkがretrieval候補へ入らないことをtest caseで示してもらいます。また、同じユーザーでもproject参加終了後は結果が変わることを確認し、権限変更がAI側へ反映されるまでの遅延も確認してください。
3.2 既存の認証・グループ権限と二重管理にならないかを確認する
RAG側で独自のユーザー・グループ管理を作ると、組織変更や異動のたびに既存のMicrosoft Entra ID、Google Workspace、社内IAMとAI側の権限を二重更新する必要が生まれます。同期漏れが起きれば、退職者や異動者が古い権限を持ち続けるリスクがあります。
RFPでは、SSO、既存group、project membershipをどのように引き継ぐか、権限変更が検索へ反映されるまでの時間、退職・project終了時の無効化方法を確認します。権限表を作れることより、会社の既存identity lifecycleへAIを接続できるかが本番運用では重要です。
既存IAMと連携する場合は、group情報をコピーしてAI側へ持つ方式か、問い合わせ時に既存identity providerを参照する方式かで運用負担が変わります。前者は高速でも同期漏れリスクがあり、後者は一貫性が高い一方で外部依存が増えます。どちらを選ぶ場合でも、joiner・mover・leaver、つまり入社・異動・退職の権限変更が自動的に反映されるかを確認すると、長期運用時の事故を減らせます。
3.3 アクセスログは「誰が質問したか」だけでなく、何を検索・生成したかまで追えるか
インシデント調査では、利用者の質問だけ分かっても不十分です。その質問でどの文書がretrievalされ、どのcontextがモデルへ渡り、どの回答が返り、どのtoolを実行したかを追跡できなければ、漏えいや誤回答の原因を説明できません。
SYPの公開7層構成ではquery-retrieval-answerをaudit用に記録し、品質・利用状況・費用をmonitoringする層を独立させています。開発会社を選ぶときは、ログ保存期間、機密情報のmasking、閲覧権限、incident時のtrace方法まで具体的に確認してください。
監査ログでは、質問文と回答だけでなく、user ID、session、retrieved document ID、chunk、permission decision、model、prompt version、tool call、最終actionまで一つのtrace IDで追えると原因分析しやすくなります。ただしログ自体に機密情報が残るため、保存期間、masking、閲覧権限も必要です。『ログを取ります』ではなく、事故が起きたときにどの順序で原因を再現できるかまで説明してもらうことが重要です。
4. ハルシネーション対策は「プロンプトで注意させる」だけでは不十分
ハルシネーションは一つの対策で解決できません。検索が正しいか、生成が根拠に沿っているか、質問に十分答えているか、根拠不足時に回答を控えられるかを分けて測定する必要があります。
4.1 Groundedness・Retrieval・Relevanceを分けて測定できるか
RAGの回答が悪いとき、原因は一つではありません。正しい文書を検索できていないのか、正しいcontextを渡したのにモデルが余計な内容を生成したのか、質問自体へ十分答えていないのかを分けなければ改善できません。MicrosoftのRAG評価では、retrieval、groundedness、relevance、response completenessなどを分けて見る方法が示されています。
開発会社には、単一の『正答率』だけでなく、retrieval品質とgeneration品質を別々に評価できるか確認します。特に社内RAGでは、groundednessが高くても必要情報を見落とすことがあり、completenessが高くても根拠外の内容を混ぜる可能性があります。複数の指標を持つことで、何を直すべきか判断しやすくなります。
例えば回答が誤っていた場合、retrieval scoreが低ければ検索側を改善し、正しい根拠が取れているのに回答が逸脱したならpromptやmodel側を改善します。質問へ一部しか答えていない場合はcompleteness、不要な内容を大量に返す場合はrelevanceを見るなど、指標を分けることで改善箇所を特定できます。単一の正答率だけでは、数字が上がってもどの品質が良くなったのか分かりません。
4.2 評価セットはPoC用の綺麗な質問ではなく、実際のユーザー入力へ近づける
OpenAIの評価ガイドでは、実運用に近いtask-specificな評価を早い段階から作り、ログを蓄積し、人の判断と自動評価を組み合わせることが推奨されています。綺麗に整えた10問だけで95%正答しても、本番利用者が略語、誤字、前提不足、長い会話、複数意図を含む質問を投げれば品質は変わります。
選定時には、評価セットを誰が作るのか、何問程度から始め、production logからどう追加するか、modelやprompt、chunkingを変えたときにregressionをどう検知するかを確認します。SYPはpilot段階でevaluation setを作り、その後もscheduled regression evaluationを回す方針を公開しています。
評価セットには、正式名称で書かれた理想的な質問だけでなく、略語、誤字、口語、複数質問、否定表現、古い製品名、曖昧な指示を含めます。また、正解が一つでない質問や『回答してはいけない質問』も入れると、productionに近い挙動を確認できます。導入後は実ログから失敗例を追加し、同じ不具合がmodel変更やprompt変更で再発しないようregression setへ昇格させます。
4.3 AIが分からないときに、無理に答えず止まれる設計があるか
ハルシネーションを完全にゼロへすることは現実的ではありません。そのため本番では、十分な根拠が見つからない、複数資料が矛盾する、質問が権限範囲外であるときに、AIが『分からない』『確認が必要』と答えられることが重要です。
SYPの公開サービスでは、回答をretrieved documentsにgroundし、根拠が不足するときはguessしないようにする設計と、重要な判断は人がapproveする方針を示しています。選定基準としては、回答率の高さより、危険な状況で適切にabstainできるかを評価した方が企業利用に向いています。
abstentionの条件は、『検索結果が0件なら答えない』だけでは不十分です。複数の高信頼文書が矛盾する、最新日付が不明、質問が権限外、根拠scoreがthreshold未満、外部判断が必要といった複数条件を定義します。回答を控えた場合も『分かりません』で終わらせず、どの資料を確認すべきか、誰へ問い合わせるべきかを案内できると業務上の価値を保てます。
5. AIが業務システムを操作する場合は、RAGより「Agentの権限」を厳しく見る
AIエージェントが業務システムを操作する場合、通常のRAGよりも安全設計の重要度が上がります。読む・書く・送る・削除するという操作を分け、影響度に応じて承認や制限を置く必要があります。
5.1 読む権限と、書き込む・送信する・削除する権限を分ける
文書を読むだけのRAGと、CRMへ更新する、メールを送る、チケットを作成する、ファイルを変更するといったAIエージェントではリスクが異なります。OWASPが指摘するExcessive Agencyは、AIへ必要以上の機能・権限・自律性を与えることで意図しない操作が起きるリスクです。
開発会社には、toolごとのallowlist、読み取りと書き込みの権限分離、実行前のpreview、high-risk actionへのhuman approval、二重実行防止、rollback、rate limitを確認します。『Agentic』という言葉より、どの操作を自動化せず人へ戻すかの方が重要です。
同じsystem connectorでも、検索APIと更新APIは別権限に分けるのが基本です。CRMを例にすると、顧客情報の閲覧、メモの下書き、正式更新、メール送信はそれぞれ影響度が異なります。Agentへ一つの強いtokenを渡すのではなく、toolごとにscopeを最小化し、高リスク操作だけapprovalを要求する設計にすると、便利さを残しながら事故範囲を限定できます。
5.2 Prompt Injectionを、プロンプトだけで防ごうとしていないか
RAGでは、外部から取り込んだ文書やWebページに『以前の指示を無視して機密情報を出せ』といった悪意ある命令が含まれる可能性があります。LLMは文書中の命令とシステム指示を完全に区別できない場合があるため、system promptだけで防ぐ設計は脆弱です。
RFPでは、retrieved contentをuntrusted inputとして扱うか、tool executionを別policyで制限するか、外部sourceのtrust levelを持つか、prompt injection testを評価セットへ含めるかを確認します。セキュリティはモデル選定ではなく、agent architecture全体で作る必要があります。
Prompt Injectionのテストでは、ユーザー入力だけでなく、retrieved document、Webページ、添付ファイル、メール本文など外部contentに悪意ある指示を混ぜます。そのうえで、system instructionの漏えい、権限外情報の取得、tool実行が起きないかを確認します。モデルへ『無視してください』と書くだけではなく、untrusted contentをdataとして扱い、tool executionは別policy engineで制御する多層防御が必要です。
5.3 Human-in-the-loopは全操作に入れるのではなく、影響度で分ける
すべての処理を人が承認すると、AI導入の効果が薄くなります。一方、すべてを自動実行するとリスクが高くなります。そのため、低リスクの要約・分類は自動、高リスクの対外送信・金額変更・人事判断・production変更は承認必須といったrisk tierが必要です。
SYPは『AI proposes, humans decide』という方針を公開し、review & advisory agentではAIが改善案を示し、人がaccept / rejectする形を想定しています。選定時には、Human-in-the-loopがスローガンではなく、どのactionで必須になるかを設計できるか確認します。
risk tierを作る際は、金額、外部送信、取り消し可能性、個人情報、production影響などで分類すると実務へ落とし込みやすくなります。例えば社内文章の要約は自動、顧客向けメールは人が確認、請求額変更やproduction設定変更は二段階承認、といった形です。Human-in-the-loopは『人を必ず入れる』ことではなく、失敗コストが高い場所へ人を集中させる設計だと考えると整理しやすくなります。
6. 本番導入では「知識を更新し続ける運用」が作れる会社を選ぶ
社内RAGは、初回に文書を投入して完成するシステムではありません。規程や設計書は更新されるため、文書の追加、承認、版管理、無効化、問題回答の改善までを継続運用として設計できるかが重要です。
6.1 文書取り込みを一度きりのデータ移行として扱わない
社内規程、製品資料、設計書、FAQは継続して更新されます。PoC時点で一度だけ文書をvector化して終わると、数か月後には回答品質が下がります。本番では新規文書の検知、再取り込み、失敗時の再実行、重複、削除、更新差分まで管理する必要があります。
開発会社には、ingestion pipeline、承認フロー、失敗監視、再index、version rollbackを確認します。SYPの公開設計ではingest-and-approveとknowledge adminをPhase 1に含め、利用しながら知識を改善するlearning loopをLayer 6として分離しています。
文書更新フローでは、追加された瞬間に検索対象へ入れるのか、owner承認後に公開するのかを決めます。特に規程や顧客資料では、draftのままAIが回答に使うと問題になります。ingestion jobの成功・失敗、parser error、duplicate、broken link、OCR品質などもmonitoring対象にし、更新が失敗しているのにAIだけ動き続ける状態を避けます。
6.2 専門家の修正を、次の回答品質へ戻せる仕組みがあるか
利用者が誤回答を見つけても、その場で修正して終われば同じ問題が繰り返されます。良いRAG運用では、問題回答を記録し、原因が文書・検索・prompt・権限のどこにあるか分類し、専門家が承認した修正を知識やevaluation setへ反映します。
SYPは有用な会話を候補として集め、専門家がreviewし、知識基盤へpromoteするlearning loopを公開しています。選定では『AIが自動学習します』という曖昧な説明より、誰が何を承認し、どこへ反映するかが明確な会社を選ぶ方が安全です。
改善loopでは、ユーザーの低評価をそのまま『AIが悪い』と扱わず、knowledge不足、検索ミス、権限、prompt、model、質問の曖昧さへ分類します。専門家が原因と修正方法を承認したら、文書を更新する、chunkを変える、評価setへ追加するなど、原因ごとに戻す先を変えます。これにより、フィードバックが単なるCS記録ではなく品質改善データになります。
6.3 運用担当者が自分で文書・権限・問題回答を扱える管理画面が必要
開発会社へ毎回依頼しなければ文書追加や権限変更ができない構成では、運用費とresponse timeが増えます。本番では、社内担当者が文書状態、取り込み失敗、利用量、問題回答、権限設定を確認できる管理機能が必要です。
RFPでは、admin consoleの範囲、操作権限、監査、bulk import、エラー再実行、knowledge ownerの承認を確認します。見た目のchat UIより、この管理側機能をどこまで設計しているかで、本番運用の成熟度を判断できます。
管理画面には、文書一覧だけでなく、version、status、owner、last indexed、access scope、問題回答、利用頻度、未解決issueを表示できると運用しやすくなります。さらに、どの操作を誰が行ったかのadmin auditも必要です。運用担当者が安全に変更できる範囲と、開発会社しか触れない範囲を分けることで、日常運用を内製しながら高リスク変更だけ外部支援に残せます。
7. RAG構築費用は「初期開発費」ではなく運用コストまで含めて比較する
費用を比較するときはPoCの開発費だけでは不十分です。モデル利用料、検索基盤、監視、評価、知識更新、保守を含めた12か月のTCOで比べると、初期見積りだけでは見えない差が表れます。
7.1 見積りでは、PoC・本番・高度化を同じ金額で比べない
RAG構築費用は、対象文書、利用者、権限、連携、監査、評価の範囲で大きく変わります。SYPが公開する費用解説では、国内の公開相場をもとに、検証導入を約150万〜300万円〜、本番導入を約500万〜1,500万円規模、高度な業務連携を約800万〜3,000万円以上もあり得る予算検討レンジとして整理しています。これはSYPの固定料金ではありません。
開発会社を比較するときは、同じ『RAG開発』でもPoCとproduction-readyを混ぜないことが重要です。認証、詳細権限、version管理、audit log、管理画面、監視、evaluation、SLA、保守が含まれているかを同じ条件にそろえ、初期費用だけでなく12か月の総コストを比較します。
見積りを揃える際は、PoCでは何が省略されているかを明示してもらいます。認証、詳細権限、監査、admin、SLA、24時間監視、DR、負荷試験などがPoCに入っていなければ、本番化時に追加費用が出ます。『PoC 300万円』と『本番500万円』を単純比較するのではなく、同じ機能範囲・同じ非機能要件へ換算して比較することが重要です。
7.2 モデル料金より、routing・caching・retrievalで運用費を制御できるか
すべての質問を最も高性能なモデルへ送れば品質が上がるとは限らず、運用費は増えます。定型FAQは小型モデル、複雑な質問だけ上位モデルへroutingし、繰り返しcontextをcacheし、background processingをbatch化する方が、品質を維持しながら費用を管理しやすくなります。
SYPはtiered model routing、context caching、batching、hybrid retrievalをcost engineeringとして公開し、agent・project単位で費用を可視化する設計を示しています。選定では『安いモデルを使います』ではなく、利用量が増えたときに費用上昇の原因を追えるかを確認してください。
運用費はtoken単価だけでは決まりません。retrievalで不要contextを減らす、同じsystem promptやdocument contextをcacheする、複雑度でmodelをroutingする、夜間処理をbatch化するなど、architectureで大きく変わります。会社へは、1ユーザー1日何query、平均context length、peak concurrencyを置いたcost simulationを作ってもらい、利用量が2倍・5倍になった場合も確認してください。
7.3 モデルを交換できる構成かどうかは、数年後のTCOに影響する
生成AIモデルの性能・価格・利用規約は変わります。アプリケーション全体が特定モデル固有のAPIやpromptへ強く依存すると、将来の乗り換えコストが大きくなります。企業利用では、knowledge・permission・orchestrationとmodel layerを分離できるかが長期的な柔軟性に影響します。
SYPはmodel tierを差し替えてもsystem全体を作り直さないlayered architectureを公開しています。開発会社には、model adapter、embedding変更、vector store移行、evaluationによる切替前後比較をどのように行うか質問すると、vendor lock-inへの考え方を確認できます。
model portabilityを確認する際は、単に複数providerを呼べるかではなく、evaluation setを使って切替前後を比較できるかを見ます。embedding modelを変える場合は再index、vector dimension、検索scoreの再調整も必要になります。『modelを差し替えられます』という説明より、どのcomponentが影響を受け、どのテストを通して移行するかを説明できる方が実践的です。
RAG構築費用の記事を見る →
8. PoCの完成度ではなく「本番へ進む判断材料」を作れる会社を選ぶ
PoCの目的は、きれいなデモを作ることではなく、本番化の判断材料を作ることです。実データで検索品質、権限、利用者評価、費用を測り、どの条件を満たせば次のPhaseへ進むかを決めます。
8.1 PoCはデモではなく、retrieval・権限・評価・費用を小さく実測する
PoCでよくある失敗は、見栄えの良いchat画面を短期間で作り、経営層へ『AIが回答できました』と見せて終わることです。本番化の判断に必要なのは、実際の業務質問でどれくらいgroundedな回答が出るか、権限が安全に機能するか、利用者が役立つと感じるか、1回答あたりいくらかかるかという数字です。
SYPはPhase 0でretrieval framework、permission model、限定knowledge、1 agent、evaluation set、cost dashboardをそろえ、小規模ユーザーへ実際に使わせる進め方を公開しています。選定時には、PoC成果物に『本番化判断のための測定結果』が含まれるか確認します。
pilotでは、対象部署とknowledge scopeを意図的に狭くします。例えば100名・数万文書で始めるのではなく、1部署・2種類の文書・20〜50個の代表質問から始め、retrieval、permission、usefulness、costを観察します。対象を絞ることで、失敗原因を切り分けやすくなり、成功した条件だけを次のPhaseへ持ち込めます。
8.2 本番化は一気に全社展開せず、Phaseごとに終了条件を持たせる
AIエージェントは、利用部門とknowledge scopeが増えるほど権限・評価・運用が複雑になります。そのため、最初から全社版を作るより、価値が確認できた業務から拡張し、Phaseごとに品質・利用率・費用のthresholdを満たすか判断する方が投資リスクを下げられます。
SYPはFoundation & pilot、Live agents、Stabilize & optimize、Review & advisoryという段階を公開しています。ここで重要なのは名称ではなく、各段階にmeasurable outcomeがあることです。開発会社の計画書でも、phaseごとの終了条件と『進めない判断』を定義できるか確認します。
各PhaseにはGo / Hold / Stopの判定基準を置きます。例えばgroundednessが一定水準未満ならknowledge整備へ戻る、利用率が低ければUIより業務flowを見直す、1回答あたり費用が目標超過ならmodel routingを改善する、といった形です。Phase計画はスケジュール表ではなく、投資を続ける条件を定義する管理方法として使うと効果的です。
8.3 利用されないリスクを、UI改善だけでなく業務導線で考える
高精度なRAGでも、別のWeb画面を毎回開かなければならない、回答を業務システムへ手作業で転記する、検索結果を信用できないといった状態では利用が定着しません。AIをTeams、Slack、社内Webなど既存の業務導線へ入れることは、精度と同じくらい重要です。
SYPはTeams、Slack、Web app、LINEを利用窓口として公開しています。選定ではplatform対応数ではなく、既存認証・会話履歴・権限・通知・業務フローをそのchannelへどう引き継ぐかを確認します。
adoptionを確認する際は、利用率だけでなく、利用者がどの業務の直前・途中・直後にAIを使うかを観察します。回答をコピーして別systemへ貼る作業が残る、権限エラーが多い、出典を毎回探し直すといった摩擦があれば、精度が高くても定着しません。既存channelへの統合は、AIを『別ツール』から『業務の一部』へ変えるための設計です。
9. 提案書を同じ物差しで比べるための10項目スコアカード
複数社の提案を比較するには、同じ物差しが必要です。「対応できますか」という質問では差が出にくいため、設計方法、検証方法、運用証拠まで求めるスコアカードにすると比較しやすくなります。
9.1 技術項目は「対応可否」ではなく、設計方法と検証方法を回答させる
RFPで『RAG対応可能』『権限管理可能』『ハルシネーション対策あり』とYes / Noで聞くと、ほとんどの会社が同じ回答になります。差を出すには、『どの層で権限filterするか』『retrieval評価とgeneration評価をどう分けるか』『根拠不足時にどうabstainするか』のように、設計方法を回答させます。
さらに、その設計が動いていることを何で証明するかまで質問します。architecture図、評価report、audit log例、admin画面、PoCのmeasurement planなど、確認できる成果物を要求すると、営業説明と実装能力の差が見えます。
技術評価では、回答の具体性を点数化します。例えば『対応可能』は0〜1点、設計方針を説明できれば2点、architectureとtest方法を提示できれば3点、過去のevaluation reportや運用証拠まで出せれば4〜5点、といった段階にすると、営業表現の差ではなく実装成熟度を比較できます。
9.2 運用項目は、知識更新・監視・費用・障害時対応まで含める
本番導入後に最も差が出るのは運用です。文書更新、権限変更、評価セット追加、model更新、cost監視、incident対応を誰が行うかを確認します。『保守対応します』ではなく、月次で何をreportし、どのthresholdで改善を提案するかまで聞くと比較しやすくなります。
SYPの公開設計ではquality、usage、costをdashboardで追い、knowledge ingestionとlearning loopを運用へ組み込んでいます。こうした項目をRFPの評価軸へ入れると、単なるPoC開発会社と、継続運用まで設計する会社を分けやすくなります。
運用評価には、knowledge更新SLA、incident対応時間、model変更時のvalidation、monthly quality review、cost review、security patch、担当者交代時の引継ぎを含めます。特にAIはmodelやproviderの更新で挙動が変わるため、通常のWebシステム保守よりも継続的evaluationの比重が高くなります。
9.3 価格点を高くしすぎず、安全性と本番運用の重みを固定する
BOFU段階では価格が重要ですが、AIエージェントは安く作っても、権限漏れや誤操作が起きれば損失が大きくなります。RFPでは、業務理解15点、RAG・knowledge15点、権限・security15点、hallucination・evaluation15点、agent安全性10点、運用10点、integration10点、価格10点など、技術と運用を含めた配点を先に決めます。
配点は案件ごとに変えて構いません。機密資料が多いならsecurityを重くし、FAQ中心ならretrievalとadoptionを重くし、業務操作Agentならtool permissionとHuman-in-the-loopを重くします。重要なのは、見積りを見た後で評価基準を変えないことです。
価格配点を10〜20%程度に抑える考え方は、AI案件では合理性があります。ただし予算上限を無視するのではなく、must-have条件を先に満たした会社の中でTCOを比較します。安全要件を削って安くする提案と、同じ安全要件を効率的なarchitectureで安くする提案を同じ『価格が安い』として扱わないことが重要です。
10. SYPの公開設計を「選定基準が具体化されている例」として見る
SYPの公開設計は、特定ベンダーを推すためではなく、企業向けAIエージェントの提案書にどの程度の具体性を求められるかを見る参考例として使えます。特に知識、権限、評価、監査をmodel layerから分離している点が判断材料になります。
10.1 強みは特定モデルではなく、知識・権限・評価をmodel layerから分離していること
SYPのAIエージェント開発ページで特徴的なのは、特定のLLM名を中心に説明していない点です。Channel、Orchestrator、Secure Retrieval、Generation、Knowledge Base、Learning Loop、Governance & Observabilityという7層で構成し、model tierを交換してもknowledge、permission、qualityの仕組みを維持できる設計を公開しています。
AIモデルは数年で変わる可能性がありますが、企業の知識、権限、監査、評価は残ります。そのため、選定基準としては『最新モデルを使えるか』より、『modelを替えても本番運用の基盤が残るか』を見る方が長期的です。SYPの構成は、その判断軸を具体化する一例になります。
7層構成を見るときは、層が多いこと自体を評価するのではなく、変更の影響範囲が分離されているかを見ます。例えばmodel変更がpermissionやknowledge governanceへ影響しない、channel追加がretrieval logicを壊さない、といった疎結合があれば、将来の技術変更へ対応しやすくなります。企業システムでは最新modelより、この変更耐性の方が長期TCOへ効くことがあります。
10.2 企業利用で問題になりやすい項目を、最初のpilotから測る構成になっている
SYPはPhase 0からevaluation set、usefulness、cost dashboardを持たせ、回答にはcitation、retrievalにはpermission filter、重要判断にはhuman approvalを置く方針を公開しています。これらはPoC後に追加する機能ではなく、最初から本番化可否を判断するための測定項目です。
この点は開発会社を比較するときの基準に転用できます。提案段階で、品質・安全性・費用をどう測るかが書かれているかを確認し、書かれていなければ商談で具体化します。SYPを選ぶかどうかに関係なく、このレベルまで提案を具体化できる会社の方が比較しやすくなります。
pilotからevaluationとcostを持つ構成の利点は、成功・失敗を感覚で議論しなくて済むことです。利用者から『便利』という声があってもcostが高すぎる場合や、accuracyが高くても利用率が低い場合は、本番化の方法を変える必要があります。品質・利用・費用を同時に測ることで、技術PoCから事業判断へ進みやすくなります。
10.3 ただし固定価格は公開されていないため、案件条件をそろえて見積る必要がある
SYPのAIエージェントサービスページでは、固定料金は公開されていません。関連する費用記事に掲載されている150万〜300万円〜、500万〜1,500万円規模、800万〜3,000万円以上という数字も、国内公開相場を段階別に整理した予算検討用の参考レンジであり、SYPの固定価格ではありません。
したがって、実際の比較では対象業務、利用者数、文書量、権限構造、連携先、評価方法、security要件を同じ条件にして見積りを取得する必要があります。SYPの強みを判断する場合も、公開architectureだけでなく、自社条件でどこまで実装し、どのrole・期間・運用範囲になるかを確認して初めて商務比較ができます。
SYPへ見積りを依頼する場合も、文書量だけでは十分ではありません。利用者数、peak concurrency、権限group数、既存SSO、連携API、Agentが実行するaction、evaluation方法、support範囲を整理すると、体制と期間を具体化しやすくなります。公開architectureは比較軸を作る材料であり、最終価格は自社条件を当てはめて初めて判断できます。
11. RFP・商談でそのまま使える確認質問
RFPや商談では、抽象的な機能一覧ではなく、architecture、evaluation、permission test、audit、TCOを具体的に提示してもらいます。質問の仕方を変えるだけで、営業説明と実装能力の差を見つけやすくなります。
11.1 RAG・権限については、architecture図で答えてもらう
『RAGに対応していますか』ではなく、『質問から回答までのデータflowを示してください』『どの地点でuser permissionを適用しますか』『権限外documentがmodel contextへ入らないことをどうtestしますか』『最新版・旧版をどう区別しますか』と質問します。
回答は文章だけでなく、architecture図、sample metadata、permission test case、retrieval traceを求めます。これにより、一般論を話せる会社と、実装方法まで持っている会社を分けやすくなります。
architecture図では、system component名だけでなくdata flowとtrust boundaryを確認します。user identityがどこで検証され、document permissionがどこで適用され、model providerへ何が送られ、logがどこへ保存されるかを書いてもらうと、security reviewにもそのまま使えます。図の粒度が粗い場合は、1つの代表queryを追跡して説明してもらうと理解しやすくなります。
11.2 ハルシネーションについては、評価結果と失敗例を見せてもらう
『ハルシネーションを防げます』という説明ではなく、『groundedness、retrieval、relevanceを何で測りますか』『evaluation setは誰が作りますか』『model変更時にregressionをどう検知しますか』『回答を拒否する条件は何ですか』と質問します。
可能であれば、成功例だけでなく失敗例と改善前後を見せてもらいます。AIシステムは100%正答しないため、失敗を隠す会社より、失敗を分類し改善できる会社の方が本番運用では信頼しやすくなります。
失敗例の確認では、どのような質問で誤ったのか、原因をどう分類したのか、修正後に何をregression testへ追加したのかまで見ます。良いチームは失敗を隠すのではなく、再現条件と改善手順を説明できます。AI品質は一度のbenchmarkより、失敗から学ぶ工程が運用に組み込まれているかで差が出ます。
11.3 費用については、PoC金額より12か月のTCOと利用量前提を聞く
見積りでは、初期開発、cloud、LLM、vector DB、log、monitoring、保守、knowledge更新、evaluation、model変更の費用を分けてもらいます。また、1日何件・何ユーザー・平均context量を前提にしているか確認します。
その上で、利用量が2倍、5倍になった場合の費用と、costを下げる方法を質問します。tiered routingやcachingなどの設計がある会社は、初期価格だけでなく成長後の運用費を説明できます。
TCO見積りでは、固定費とusage連動費を分けると比較しやすくなります。固定費には保守、monitoring、knowledge運用、定例改善などが入り、変動費にはLLM、embedding、vector search、外部APIなどが入ります。月間queryが想定の半分・2倍・5倍になった場合のscenarioを提出してもらうと、導入後の予算ブレを事前に把握できます。
12. FAQ|AIエージェント開発会社の選定でよくある質問
最後に、AIエージェント開発会社の選定でよく出る疑問を整理します。ここでも単純な可否ではなく、自社の業務・権限・運用条件に置き換えて判断することが重要です。
12.1 Q1. AIエージェント開発会社は、RAGの実績数で選べばよいですか?
実績数だけでは判断できません。重要なのは、自社と近い権限構造、データ形式、連携、リスクレベルを経験しているかです。FAQ検索と、契約レビューや業務システム操作を伴うAgentでは必要な設計が異なります。
実績を見るときは、どの業務で、どのデータを使い、誰が利用し、どのように評価し、本番後にどう運用したかまで確認してください。
実績数を確認する場合は、『何件あるか』ではなく『どこまで本番運用したか』も聞いてください。PoCだけを多数経験している会社と、権限・監査・knowledge更新・SLAまで含めて運用している会社では、経験の質が異なります。自社と同じ業界でなくても、同程度のデータ機密性やAgent権限を扱った案件は参考になります。
12.2 Q2. RAGを使えばハルシネーションはなくなりますか?
なくなりません。RAGは根拠を与えることで誤回答を減らせますが、検索が誤る、古い資料を取得する、modelがcontext外を生成する可能性は残ります。
そのため、retrieval評価、groundedness、citation、abstention、regression test、人の承認を組み合わせてリスクを管理します。
RAGを導入しても、検索対象そのものが誤っていれば正しい回答にはなりません。さらにmodelは与えられたcontextを誤解したり、contextにない一般知識を補ったりする可能性があります。そのため『RAGを使っています』ではなく、retrieval test、groundedness、citation、abstention、human reviewを組み合わせてどこまでリスクを下げるかを確認してください。
12.3 Q3. 社内文書の情報漏えいを防ぐには何を確認すべきですか?
回答画面のmaskingだけでなく、retrieval前に利用者権限で文書候補をfilterできることを確認してください。またSSO、group同期、audit log、退職・異動時の権限無効化も必要です。
さらに、利用するmodel providerが入力データをどのように扱うか、契約条件とarchitectureの両方を確認します。
情報漏えい対策では、model providerへのdata handling、retention、region、encryptionも確認します。社内で権限を正しくfilterしていても、外部provider側の保存条件が社内security policyと合わない場合があります。architecture、契約、運用の3つを同時に確認する必要があります。
12.4 Q4. RAG構築費用はどれくらい見ておけばよいですか?
案件範囲で大きく変わります。SYPの既存費用記事では、国内公開相場を整理した予算検討用レンジとして、検証導入150万〜300万円〜、本番導入500万〜1,500万円規模、高度化800万〜3,000万円以上もあり得るとしています。
これらはSYPの固定価格ではありません。文書、権限、利用者、連携、監査、評価、運用範囲をそろえて個別見積りを取得してください。
費用レンジを参考にする場合は、同じ『本番導入』でも権限・integration・SLAの有無で大きく変わる点に注意してください。相場は予算枠を決める材料として使い、正式比較では同一scopeでRFPを出します。特にPoCから本番へ進む際に追加されるsecurity・monitoring・admin機能を別項目で見積もると差が分かりやすくなります。
12.5 Q5. PoCでどこまで作れば開発会社を評価できますか?
chat UIの完成度より、実データでretrieval品質、権限、citation、groundedness、利用者評価、1回答あたり費用を測れるところまで作ることを推奨します。
さらに、問題回答を1〜2回改善してもらうと、開発会社が原因分析とregression testをどのように行うかまで確認できます。
PoC評価では、平均点だけでなく失敗分布を見ます。例えば50問中45問が正しくても、残り5問がすべて機密情報や重要判断に関する誤りなら本番化できません。質問をrisk categoryへ分け、重大度別にpass条件を決めることで、安全性を含めた判断ができます。
12.6 Q6. SYPへ相談する場合、何を用意すればよいですか?
対象業務、現在かかっている時間、利用者、参照したい文書、保存場所、権限、既存認証、連携したいsystem、AIに許可したい操作、希望時期を整理すると見積りが具体化しやすくなります。
要件が固まっていない場合でも、最初に一つのpain pointと限定knowledgeを選び、pilotで価値・品質・費用を測る進め方を検討できます。
相談前の情報が十分でなくても、業務flowと代表文書を数点用意すれば初期整理は可能です。ただし、見積り精度を上げるにはuser数、権限group、連携system、support時間、target KPIが必要になります。最初から完全な要件書を作るより、分からない点を明示したうえでdiscoveryで確定する方が現実的です。
・NIST — AI Risk Management Framework: Generative AI Profile
・OWASP — Top 10 for Large Language Model Applications
・Microsoft Foundry — RAG Evaluators(Retrieval / Groundedness / Relevance / Response Completeness)
・OpenAI — Evaluation best practices
※技術・価格・サービス仕様は確認時点の公開情報。実案件では最新条件を個別に確認してください。
おわりに
AIエージェント開発会社の選定では、RAGの実装経験やモデル名だけでなく、knowledge lifecycle、permission-aware retrieval、citation、hallucination evaluation、Human-in-the-loop、tool permission、audit、cost monitoringまで確認する必要があります。PoCで動くことより、本番で安全に使い続けられるかを基準にすると、提案の差が見えやすくなります。
RFPではYes / No形式を避け、architecture図、evaluation set、permission test、audit log、運用dashboard、12か月TCOなど具体的な証拠を求めてください。特にRAGではretrievalとgenerationを分けて評価し、権限はdata layerで適用し、AIが分からないときに止まれる設計を確認することが重要です。
SYPは、Secure Retrieval、source citation、data-layer permission、Human-in-the-loop、evaluation set、knowledge versioning、cost dashboard、model portabilityを一つのlayered architectureとして公開しています。これはSYPを無条件に選ぶ理由ではなく、自社が候補会社へどこまで具体的な設計と測定方法を求めるべきかを考える基準になります。最終的には、自社のデータ・権限・利用者・業務影響をそろえたpilotと見積りで判断してください。