社内RAG・AIエージェント開発の費用と進め方|検証導入から本番まで
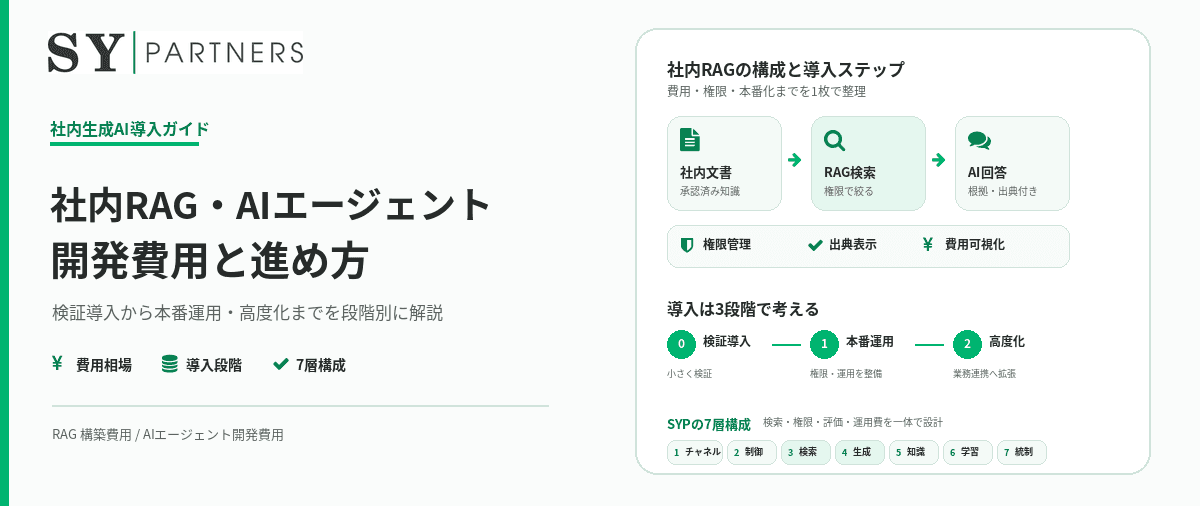
社内文書を検索して回答するRAGや、資料の確認、報告書の下書き、レビュー支援まで担うAIエージェントは、単なる新機能ではなく、社内情報の探し方や業務の進め方そのものを変える仕組みとして検討されるようになっています。一方、導入を具体化する段階になると、多くの企業が最初にぶつかるのが「結局、どこまで作ればよく、どの程度の費用を見ておけばよいのか」という問題です。同じ「社内RAG」という呼び方でも、数百件の承認済み資料だけを検索する小規模な検証環境と、複数部署の権限を引き継ぎ、監査記録を残し、日常的な業務システムと連携する本番環境では、必要な設計も開発量も大きく異なります。
費用を分かりにくくしている理由の一つは、生成AIそのものの利用料だけを見ても全体像がつかめないことです。実際の企業導入では、文書を取り込む前の整理、古い版や重複資料の扱い、利用者ごとの閲覧権限、検索方法、回答の根拠表示、品質評価、利用記録、知識更新、障害時の対応など、AIが回答を作る前後に多くの仕組みが必要になります。そのため見積りを比較するときは、「どのモデルを使うか」だけではなく、「業務へ安全に組み込むために何が含まれているか」を確認する必要があります。
SY Partners(以下、SYP)のAIエージェント開発では、最初から全社規模の仕組みを完成させるのではなく、対象業務、利用者、参照する知識を絞った検証導入から始め、実際の回答品質、利用状況、費用を確認しながら段階的に本番へ広げる考え方を採用しています。この進め方の利点は、初期費用を抑えやすいことだけではありません。どの業務で効果が出るのか、どの種類の文書では精度が落ちるのか、どの程度の権限設計が必要なのかを実データで把握したうえで、次の投資判断を行える点にあります。
本記事では、国内で公開されている生成AI開発の参考相場をもとに、第0段階、第1段階、第2段階でどの程度の予算を考えるべきかを整理します。そのうえで、SYPが示している7層のRAG・複数エージェント構成を手掛かりに、検索、権限、知識管理、評価、監視までをどのように考えればよいか、さらに開発費だけでなく運用費や費用対効果をどのように判断すべきかまで詳しく解説します。
1. 社内RAG・AIエージェント開発はいくらかかるのか
1.1 「RAG構築費用」はチャット画面の制作費ではない
RAGは、利用者の質問を受け取り、社内文書から関連情報を検索し、その根拠をもとにAIが回答を生成する仕組みです。しかし企業で使う場合、文書を検索できるだけでは本番環境として十分ではありません。誰がどの資料を参照できるか、旧版を誤って使わないか、回答の根拠を確認できるか、問題が起きたときにどの情報が利用されたのかを追跡できるかまで設計する必要があります。
例えば検索結果に正しい資料が含まれていても、新旧の規程を区別できなければ、AIは古い情報を根拠に自然な文章を作ってしまう可能性があります。また、権限制御を回答画面だけで行うと、本来見てはいけない文書が生成処理へ渡る危険があります。企業向けRAGでは、回答文そのものよりも、その回答が作られるまでの情報経路を安全に設計することが開発費の中心になります。
1.2 予算検討の目安を第0・第1・第2段階に分けて考える
公開されている国内の生成AI受託開発相場を見ると、小規模な概念実証では150万〜300万円前後、中規模な社内利用では数百万円から1,000万円を超える規模、複数システムとの連携や全社利用を前提とする案件ではさらに大きな予算になる例があります。相場に幅があるのは、開発会社ごとの単価差だけでなく、対象となる文書、権限、評価、管理機能、連携範囲が案件ごとに大きく異なるためです。
価値・品質・費用を小さく測る
認証・権限・知識更新を本番化
業務連携・レビュー・複数エージェント
| 段階 | 主な目的 | 予算検討用の参考レンジ | 主な対象 | 次に判断すること |
|---|---|---|---|---|
| 第0段階 | 実業務で価値が出るかを確かめる | 約150万〜300万円〜 | 限定データ、1つの利用場面、基本権限、出典、評価 | 本番化する価値があるか |
| 第1段階 | 日常業務で継続利用できる状態にする | 約500万〜1,500万円規模 | 認証、詳細権限、知識管理、監視、利用窓口 | どの部署・用途まで拡大するか |
| 第2段階 | 業務システムとつなぎ、レビューや助言へ広げる | 約800万〜3,000万円以上も | 複数システム連携、レビュー、複数エージェント、監査 | 全社基盤として継続投資するか |
費用について:上記はSYPの固定料金ではありません。国内で公開されている生成AI受託開発の相場を、SYPの段階的な導入方法に当てはめた予算検討用の目安です。実際の見積りは、対象データ、利用者数、権限構造、連携先、セキュリティ要件、評価方法によって変わります。
1.3 金額だけでなく「何を検証するための費用か」を確認する
概念実証でよくある失敗は、予算を小さくするために評価や権限設計まで削り、単に「質問すると答える画面」だけを作ることです。それでは、本番へ進むべきかを判断する材料がほとんど残りません。費用を抑えたい場合は、必要な設計を薄くするのではなく、対象業務、利用者、文書範囲を狭くする方が効果的です。
例えば「全社員が全社文書を検索できるAI」ではなく、「営業部20名が、承認済みの製品資料と提案資料だけを検索できるAI」から始めれば、正解となる文書、評価する質問、権限条件、利用場面を明確にできます。小さく始めるとは品質を下げることではなく、検証したい仮説を明確にすることです。
2. 第0段階では「本番へ進む根拠」を作る
2.1 最初から本番を作るのではなく、判断できる検証環境を作る
SYPの第0段階では、検索基盤、権限モデル、限定された知識、1つのエージェントを用意し、評価用の質問と費用の可視化まで含めて検証します。ここで重要なのは、後から捨てることを前提としたデモにしないことです。検索、権限、評価の基本構造を持っておけば、結果が良かった場合に第1段階へ引き継ぎやすくなります。
この段階では、見た目の完成度よりも、後から結果を説明できる構造を優先します。どの質問でどの文書が検索されたのか、どの回答が利用者に役立ったのか、どこで回答を控えたのかを記録できれば、本番化の議論を感覚ではなく事実に基づいて進められます。
2.2 対象文書は「多いほど良い」とは限らない
最初の検証では、できるだけ多くの社内文書を取り込む必要はありません。むしろ最新版が明確で、内容を業務担当者が確認でき、利用頻度の高い課題に関係する資料を選ぶ方が評価しやすくなります。資料を広げすぎると、回答が悪かったときに、文書の質が原因なのか、検索設定が原因なのかを切り分けにくくなります。
表計算、スキャンPDF、図表の多い資料などは、単純に文字だけを抜き出すと意味が失われる場合があります。文書数が少なくても形式が複雑なら取り込みに工数がかかるため、見積り時には「何件あるか」だけでなく、「どの形式で、どの程度整理されているか」を確認する必要があります。
2.3 第0段階で測るべき指標
技術面では、必要な文書を上位に取得できるか、回答が質問に合っているか、出典が一致しているか、権限外の情報を取得していないかを確認します。一方、業務面では、検索時間が何分短くなったか、問い合わせ件数が減ったか、利用者が継続して使いたいと感じるかを確認します。
- 検索品質:必要な文書を正しく取得できるか
- 回答品質:取得した根拠から過不足なく回答できるか
- 出典確認:利用者が元文書へ戻って検証できるか
- 権限安全性:閲覧できない文書が検索候補へ入っていないか
- 利用単価:1質問、1利用者、1業務あたりの費用はいくらか
- 業務効果:検索時間や問い合わせ時間が実際に減ったか
2.4 終了条件を開始前に決める
検証が長期化する大きな理由は、「どこまで行けば成功なのか」が決まっていないことです。「精度が高ければ本番化する」という条件では判断できません。例えば、検索上位への正しい資料の出現率、利用者評価、平均回答時間、一質問あたりの費用、権限違反ゼロなど、次の投資判断に使う条件を開始前に定義します。
また、外部の開発費だけでなく、社内側の確認工数も計画に含める必要があります。「この規程が最新版か」「この回答が業務上正しいか」を判断できるのは、自社の担当者です。専門家が確認する時間を確保できないと、技術開発が完了しても評価だけが進まない状態になります。
3. 第1段階では「試せるAI」を日常業務で使える仕組みに変える
3.1 本番化で増えるのは利用者数よりも運用項目
第0段階で回答品質が確認できても、そのまま全社公開できるとは限りません。本番では、利用者を正しく認証し、役割や案件ごとに参照できる文書を変え、誰がどの質問をしたのかを追跡できる必要があります。また、文書が更新された際に再取り込みし、古い情報を無効化する仕組みも必要です。
本番運用では「知識の責任者」も明確にします。例えば人事規程を更新した場合、誰が旧版を無効化し、いつ新版を反映するのかが決まっていなければ、RAGは時間とともに古くなります。長期的な品質は、モデルの性能以上に、正しい知識を継続して供給できる運用によって左右されます。
3.2 Microsoft TeamsやSlackへ組み込むときに必要な設計
利用率を高めるには、社員が普段使っている場所へAIを置くことが有効です。SYPの構成では、Microsoft Teams、Slack、自社ウェブなどを利用窓口として想定しています。ただし、単にチャット画面をつなぐだけでは十分ではありません。組織の認証情報をどのように引き継ぐか、会話履歴をどの範囲で保持するか、個人チャットと案件チャンネルで検索範囲を変えるかなどのルールが必要です。
利用場所は操作性だけでなく権限にも影響します。同じ利用者でも、個人で質問している場合と特定案件の共有空間から質問している場合では、期待する情報範囲が異なることがあります。「誰が質問しているか」だけでなく、「どの業務空間から質問しているか」を条件に検索対象を変える設計が必要になることもあります。
3.3 管理者向け機能が本番費用を押し上げる
一般利用者には一つの質問欄しか見えなくても、裏側では文書の登録状況、失敗した取り込み、権限設定、利用量、問題回答、モデル別の費用などを確認する画面が必要になります。本番環境では、利用者の画面よりも運用者のための仕組みの方が多くの設計項目を持つことも珍しくありません。
また、文書が取得できない、権限情報が不足している、外部サービスが一時停止しているといった例外にも対応する必要があります。検証環境では手作業で直せる問題も、本番では利用者に影響を与えるため、再実行、通知、記録、復旧手順まで設計します。
4. 第2段階では「答えるAI」から「業務を読み、改善案を示すAI」へ広げる
4.1 レビュー支援では、人が読む範囲を絞る
SYPの第2段階では、プロジェクト管理システムや文書システムと連携し、実際の成果物を確認する利用方法を想定しています。例えば、要件定義書の抜け漏れ、設計書同士の矛盾、期限を超えたタスク、プロジェクト上のリスクを検出し、確認すべき箇所を整理する使い方です。
ここで得られる価値は、単純な検索時間の削減だけではありません。人が100ページを最初から読むのではなく、AIが根拠付きで注意点を整理し、人は判断が必要な箇所へ集中できます。AIが最終判断を代替するのではなく、人の注意力を重要な場所へ再配分する仕組みとして考えると、業務効果を設計しやすくなります。
4.2 自動化を広げるほど、人が承認する場所を明確にする
AIエージェントが業務へ深く入るほど、「どこまで自動で実行し、どこで人の確認を必須にするか」が重要です。例えば報告書の下書きは自動生成しても、顧客への送信や契約に関わる判断は人が承認する、といった境界を設けます。
承認点を入れると自動化率は低く見えますが、企業利用ではむしろ運用可能性が高まります。誤った処理が起きた場合の影響を限定でき、責任の所在も明確になるためです。とくに顧客、金額、人事、品質判定に関わる処理では、AIの提案と人の確定を分ける設計が現実的です。
4.3 費用は接続先の数だけではなく、業務への影響で変わる
外部システムから情報を読むだけの連携と、AIが内容を判断してシステムへ書き戻す連携では、必要な設計が大きく異なります。書き戻しを行う場合は、権限、承認、二重登録の防止、失敗時の復旧、操作履歴などが必要になります。
そのため第2段階の見積りでは、「何個のシステムとつなぐか」だけでなく、「AIの出力が間違った場合に何が起きるか」を確認します。影響が大きい業務ほど、開発の中心は接続処理そのものよりも、安全策、試験、監査へ移ります。
5. 同じRAGでも費用差が生まれる6つの理由
5.1 データ整備:量よりも「正しい状態で使えるか」
文書数が多いこと自体よりも、最新版が分かるか、重複を除けるか、表や図を適切に取り込めるか、部署や機密度などの情報を付けられるかが重要です。文書が整理されていない場合は、AI開発の前に情報整理が必要になり、その分の工数が費用へ反映されます。
ここを省くと、検索の技術をどれだけ改善しても「古い資料を正確に探し出す」という状態になりかねません。RAGの品質を高めるには、検索方式だけでなく、検索対象となる知識そのものを管理する必要があります。
5.2 権限管理:回答画面ではなく検索段階で除外する
SYPでは、役割、レベル、プロジェクト単位のアクセス制御をデータ層で行い、権限外の情報が回答の材料に入る前に除外する設計を採っています。AIが一度情報を受け取った後に表示だけ隠す方法では、企業の情報管理として十分とは言えません。
既存の社内権限をそのまま利用できるかどうかも費用に影響します。部署、案件、役職の情報が整理されていれば接続しやすい一方、共有フォルダごとに個別設定が積み重なっている場合は、RAG側で一貫した規則へ整理する作業が必要です。
5.3 検索と評価:「何を正解とするか」を用意する
意味による検索とキーワード検索を組み合わせる方法は、専門用語、製品番号、固有名詞、文章表現の違いを補うために有効です。しかし検索方式を導入するだけでは、品質が良いことを証明できません。「この質問ではこの文書が上位に来るべき」という評価用の組み合わせを用意し、変更後も品質が落ちていないかを確認する必要があります。
また、失敗の種類を分けて記録することも重要です。必要な文書を検索できなかったのか、文書は取れたが回答がずれたのか、そもそも資料に答えが存在しなかったのかで、改善方法は異なります。この分類ができれば、調整費用を必要な箇所へ集中できます。
5.4 システム連携:読むだけか、更新まで行うか
外部システムから情報を読むだけなら比較的設計しやすい一方、AIが登録や更新まで行う場合は、権限、承認、重複防止、失敗時の復旧が必要です。「社内データベースと連携する」という一文だけでは、見積りを判断できません。
何を読み、どの情報を組み合わせ、何を提案し、どこまで自動で操作するのかを業務単位で分けて考える必要があります。同じ接続先でも、閲覧だけの用途と業務処理を伴う用途では必要な安全設計が大きく変わります。
5.5 利用窓口:どこで使うかによって必要設計が違う
Microsoft Teamsで使う場合、自社ウェブへ埋め込む場合、顧客向けの窓口で使う場合では、認証、表示できる情報量、会話履歴、利用者属性が異なります。技術的に接続できるかだけでなく、その場所で自然に使えるかを考える必要があります。
利用者が普段開かない専用画面を新しく作ると、AIの品質が高くても定着しないことがあります。導入費用を考える際は、機能開発だけでなく、現在の業務導線へどのように組み込むかも重要な設計項目です。
5.6 統制・監視:何が起きたかを説明できる状態を作る
企業利用では、AIが答えた内容だけでなく、どの質問に対してどの資料を検索し、どのモデルで回答し、誰が利用したかを追跡できることが重要です。SYPの7層構成では、品質、利用状況、費用、監査記録を確認する層を独立して設けています。
監視を整えると、障害対応だけでなく費用管理にも役立ちます。特定部署だけ一回の質問で大量の文書を参照している、同じ質問が繰り返されている、高性能モデルの利用が想定以上に増えているといった傾向を把握できれば、検索設定や利用ルールを見直せます。
6. SYPの7層RAG・複数エージェント構成から費用の中身を理解する
6.1 第1層:利用者がAIへアクセスする窓口
Microsoft Teams、Slack、自社ウェブなど、利用者がAIへ質問する入口です。単独のウェブ画面だけなら比較的単純ですが、複数の窓口へ展開する場合は、認証や会話履歴、権限の引き継ぎ方法まで設計する必要があります。
6.2 第2層:質問と処理を適切な先へ振り分ける
利用者の本人確認、権限、質問の意図や難易度を判断し、適切な知識範囲やエージェント、モデルへ処理を振り分けます。複数部署、複数用途へ広げるほど、この振り分けが重要になります。
ここが弱いと、正しい知識基盤があっても別部署の情報を検索してしまうなど、利用体験と安全性の両方に影響します。複数のAI機能を一つの入口へまとめる場合は、何をどこへ渡すかを決める規則が必要です。
6.3 第3層:安全な検索
社内知識に対して意味による検索とキーワード検索を組み合わせ、利用者の権限に合う情報だけを取得します。回答品質が悪い場合、生成モデルを変更すれば直るとは限りません。そもそも検索段階で必要な資料を取得できていなければ、高性能なモデルでも正しい回答は作れません。
6.4 第4層:根拠に基づいて回答を生成する
検索した情報をもとに回答を作り、参照した出典を返します。すべての質問に最も高性能なモデルを使う必要はなく、定型的な質問には軽量なモデル、複雑な質問には高性能なモデルを使うことで、品質と費用のバランスを取ります。
6.5 第5層:知識基盤を管理する
原本文書、検索用データ、文書種別、対象部署、機密度、信頼度、版情報などを管理します。企業RAGでは、どの情報を検索できるかだけでなく、その情報が現在も有効か、誰向けか、どの程度信頼できるかを管理する必要があります。
新しい文書を追加する入口だけでなく、古い版を検索対象から外す出口も必要です。登録日、最終更新日、責任部署、有効期限を持たせることで、時間とともに知識が劣化することを防ぎやすくなります。
6.6 第6層:利用しながら知識を改善する
利用者との会話から有用な知識候補を抽出し、専門家が確認したうえで正式な知識へ反映します。すべての会話を自動的に学習させるのではなく、人の確認を通して正式な知識へ昇格させることで、誤情報の蓄積を防ぎながら対象範囲を広げられます。
6.7 第7層:品質・利用状況・費用を監視する
権限、監査記録、品質、利用状況、費用を確認し、どの機能を改善すべきかを判断できる状態にします。利用が多いのに評価が低い業務は改善効果が大きく、利用が少なく費用だけ高い機能は見直し候補になります。
| 層 | 主な役割 | 費用に影響する要素 |
|---|---|---|
| 第1層 | 利用窓口 | 利用チャネル数、認証方法、画面統合 |
| 第2層 | 処理の振り分け | 用途数、エージェント数、質問分類 |
| 第3層 | 安全な検索 | 検索方式、権限条件、文書量 |
| 第4層 | 回答生成 | モデル構成、出典表示、回答規則 |
| 第5層 | 知識基盤 | 版管理、承認、更新頻度 |
| 第6層 | 知識改善 | 専門家確認、会話からの知識候補抽出 |
| 第7層 | 統制・監視 | 監査記録、品質評価、利用量、費用分析 |
7. 検証導入から本番まで、どの順番で進めるべきか
7.1 最初に「AIで何を作るか」ではなく「どの業務を変えるか」を決める
「社内生成AIを導入したい」だけでは、適切な範囲を決められません。「営業担当が過去提案を探すのに1件20分かかっている」「設計レビューで見落としが起きる」「新人が手順を探すため毎回先輩へ質問している」など、現在の業務負荷を具体化します。
業務課題を具体化すると、必要なデータも自然に絞られます。営業提案の準備時間を短くすることが目的なら、最初から全社規程や人事文書まで取り込む必要はありません。過去提案、製品資料、価格表など、実際の判断に使う資料へ集中した方が効果を確認しやすくなります。
7.2 第0段階:対象を絞って実用性を確かめる
対象部署と知識範囲を絞り、実際の利用者に使ってもらいます。検索品質、回答品質、利用者評価、平均費用を測り、問題があれば文書の分割、検索条件、権限、回答規則など原因を切り分けて改善します。
良い回答だけでなく、回答できなかった質問や利用者が聞き直した質問も記録します。実際の利用者がどのような言葉で質問するかは、設計者が事前に想像した質問とは異なることが多く、こうした記録が本番化に必要な改善点を示します。
7.3 第1段階:日常業務へ組み込み、知識更新を仕組み化する
認証、権限、管理機能、利用者からの評価、監視を整え、毎日利用できる状態へ広げます。文書の追加、無効化、権限変更、問題回答の確認などを社内の運用担当者が実行できれば、改善速度が上がり、保守費用も予測しやすくなります。
7.4 第1.5段階:品質と費用を安定させる
本番導入後は、知識範囲を広げ、取り込みと承認の流れを標準化し、モデルの使い分け、一時保存、一括処理などを調整します。評価用の質問を定期的に実行し、改善によって別の質問の品質が落ちていないかも確認します。
精度改善と費用削減は別々に行う必要はありません。参照文書が多すぎる質問を特定して検索条件を改善すれば、不要な生成処理を減らしながら、回答の焦点も合わせられます。
7.5 第2段階:業務システムとつなぎ、確認・助言へ広げる
実際のプロジェクトデータや成果物を扱い、質問応答の先へ進みます。ここでは自動化率そのものを目的にせず、人が判断すべき点を明確にしたうえで、AIに任せる範囲を段階的に広げることが重要です。
- 第0段階:価値、品質、費用を小さな範囲で測る
- 第1段階:権限、知識更新、利用窓口、監視を本番化する
- 第1.5段階:品質と運用費を安定させる
- 第2段階:システム連携やレビュー支援へ広げる
8. 開発費だけでなく、運用費も設計する
8.1 継続的に発生する主な費用
本番導入後には、生成モデルの利用料、検索基盤、データベース、クラウド基盤、ログ保存、監視、文書再取り込み、品質評価、保守改善などの費用が発生します。利用者数が増えれば単純に比例して増えるとは限らず、一回の質問で渡す文書量や使うモデルによって単価が変わります。
検索が粗く、大量の文書を毎回モデルへ渡す構成では、回答品質だけでなく費用面でも不利になります。必要な根拠を少ない文書から正確に取得できるようにすることは、精度改善と運用費削減の両方につながります。
8.2 高性能モデルをすべての質問に使わない
SYPでは、定型的な質問には比較的軽いモデルを使い、複雑な質問だけ高性能なモデルへ切り替える考え方を示しています。社内問い合わせの多くが定型的であれば、すべてを同じ高価なモデルへ送る必要はありません。
さらに、繰り返し使う情報の一時保存、リアルタイム性を必要としない処理の一括実行、検索条件の改善などを組み合わせることで、利用者が増えても費用を管理しやすくなります。
8.3 月額総額ではなく、単位費用と業務効果を一緒に見る
月100万円という数字だけでは、高いか安いかを判断できません。100人が毎日使い、数千時間の調査時間を削減しているなら投資価値がある可能性があります。逆に利用者が少なく、業務削減効果も測れていないなら見直しが必要です。
一質問あたりの費用、部署ごとの費用、再質問率、平均回答時間、削減できた作業時間を合わせて確認すると、単なる節約ではなく、業務価値を維持しながら費用を最適化できます。
9. 既製サービス、自社RAG、自社モデル運用はどう選ぶか
9.1 既製のクラウド型サービス:短期間で始めたい場合
既製サービスは立ち上げが速く、初期開発を抑えやすい点が利点です。社内FAQや比較的単純な文書検索など、要件が標準機能に合う場合には有力な選択肢になります。
一方、独自の権限、複雑な検索制御、複数システム連携が必要になると、製品側の制約や追加費用が問題になる場合があります。初期費用だけでなく、利用者課金や追加機能を含めた長期費用まで確認することが重要です。
9.2 自社RAG+外部言語モデル:柔軟性と費用を両立しやすい
SYPが中間的な選択肢として示しているのが、検索や処理の振り分けを自社要件に合わせて構築し、言語モデル部分は外部サービスとして利用する方法です。知識や権限を自社要件へ合わせながら、用途に応じてモデルを変更しやすい点が特徴です。
将来、価格や性能の条件が変わっても、システム全体を作り直さず、モデル部分だけ見直しやすくなります。一方で既製サービスより設計項目が増えるため、運用責任者と保守体制を明確にする必要があります。
9.3 自社環境でのモデル運用:明確な理由がある場合に検討する
自社の計算環境でモデルを運用すれば、外部へ生成処理を送らない構成を作れます。ただし、計算資源、モデル更新、監視、性能調整などを自社で維持する必要があります。
外部サービスの利用料を抑えたいという理由だけで選ぶと、総保有コストが大きくなる場合があります。非常に大規模で安定した利用量がある、データ所在に厳しい要件があるなど、明確な条件がある場合に検討する方法です。
10. 導入できるかではなく、投資に見合うかを数字で考える
10.1 費用対効果は「削減時間 × 対象人数」から考えられる
例えば20名の担当者が資料検索に1日15分使っているとします。月20営業日なら月100時間です。RAG導入でその半分を削減できれば、月50時間の削減になります。ここに社内の時間単価を掛けることで、金額換算した効果を試算できます。
ただし、AIで作業時間がゼロになると仮定してはいけません。回答の確認や例外対応には時間が残ります。まず検証導入で実際の短縮時間を測り、その実測値を対象人数へ広げる方が、経営判断に使える現実的な数字になります。
10.2 評価指標は回答精度だけにしない
検索精度や回答品質は重要ですが、経営判断には業務指標も必要です。検索時間、問い合わせ件数、レビュー時間、利用率、再質問率、出典参照率などを組み合わせることで、「AIが賢いか」ではなく「仕事が変わったか」を評価できます。
業務によっては、時間短縮よりも品質のばらつきを減らす効果の方が大きい場合があります。新人と熟練者で回答に差がある問い合わせ業務では、承認済み知識を共通の根拠として提示することで、調査方法や回答品質をそろえやすくなります。
10.3 拡大しない判断も検証の成果
検証導入の結果、対象業務では十分な効果が出ない場合もあります。そのとき無理に全社展開するのではなく、対象業務を変更する、既製サービスで代替する、先に文書管理を改善する、いったん停止するという判断も合理的です。
段階導入の価値は、成功したときに拡大しやすいことだけではありません。効果が低い場合に大きな投資を避け、次に何を改善すべきかを明らかにできることも重要です。
11. 見積りを具体化するために整理しておきたいこと
11.1 業務:現在の作業手順を具体化する
「何をAIにやらせたいか」より先に、現在の作業手順を書き出します。誰が何を探し、どの資料を比較し、どこで判断し、最終的に何を作るのかを確認すれば、AIへ任せる部分と人が残す部分を切り分けやすくなります。
- 誰が、どの業務で使うのか
- 現在、検索・作成・レビューにどれくらい時間がかかっているか
- 回答だけでよいのか、提案や操作まで必要か
- 何をもって導入成功と判断するか
11.2 データ:保存場所、形式、更新頻度を確認する
データについては件数だけでなく、保存場所、更新頻度、版管理、閲覧権限、形式を確認します。数百件でも毎週更新される資料と、数万件でもほとんど変わらない過去資料では、必要な取り込み設計が異なります。
- PDF、Word、Excel、社内Wiki、共有フォルダなどの所在
- 最新版と旧版を区別できるか
- 部署、機密度、案件などの情報が付いているか
- スキャン資料、表、図がどの程度含まれるか
11.3 権限・セキュリティ:誰が何を見られるか
権限は「社外秘かどうか」だけではなく、部署、役職、案件、顧客など複数の軸で考えます。既存システムでどこまで権限情報を持っているか、RAG側で新しく管理する必要があるかを確認できると、見積りを具体化できます。
- 部署・役職・プロジェクト・顧客単位の閲覧制御
- 既存の認証方式
- 利用記録の保存要件
- 個人情報・機密情報の取り扱いルール
11.4 予算・期間:一度に全部完成させない
予算が限定されている場合でも、要件を薄く広げるより、一つの業務課題を深く検証した方が次の判断につながります。「全体で将来やりたいこと」と「最初に検証したい業務」を分けて整理すると、第0段階の範囲を決めやすくなります。
予算と期間を先に固定しすぎると、必要な安全設計まで削ることがあります。「この予算で何を検証すれば、次の判断に必要な情報が得られるか」という順番で考える方が、段階導入には適しています。
12. 社内RAG・AIエージェント導入でよくある質問
12.1 概念実証はいくらから始められますか?
公開されている国内相場では、小規模な生成AIの概念実証は150万〜300万円前後が一つの参考になります。ただし、対象データの整理状況、権限、外部連携、評価方法によって費用は変わります。
重要なのは最安の検証を作ることではなく、本番判断に必要な数字を取れる範囲にすることです。対象業務と終了条件を同時に決めることで、予算を抑えながら判断材料を得やすくなります。
12.2 プロジェクトや顧客をまたいで情報が漏れる心配はありませんか?
SYPでは、知識にプロジェクト、顧客、機密度などの情報を付け、AIへ渡す前の検索段階で利用者の権限を適用する考え方を採っています。また、アクセスを記録して確認できる構成を想定しています。
重要なのは、回答を表示する直前に隠すのではなく、検索段階で権限外の文書を候補から除外することです。
12.3 誤った回答を完全に防げますか?
生成AIの誤回答を完全にゼロにすることを前提とするのではなく、承認された文書を根拠に回答し、出典を表示し、十分な根拠がない場合には無理に答えない設計にします。
さらに評価用の質問を継続的に実行し、検索設定やモデルを変更した後に品質が落ちていないかを確認します。実務では「誤りをゼロにする」より、「根拠のない回答を減らし、問題を検知できる」仕組みが重要です。
12.4 社内データが外部モデルの学習に使われませんか?
SYPでは、入力データをモデル学習に利用しない条件を明示する事業者や利用経路を優先する考え方を示しています。実際には、採用するモデル、クラウド、契約内容ごとに利用条件を確認する必要があります。
契約条件だけでなく、どの情報を外部へ送るか、利用記録をどこに保存するか、機密情報をどの段階で除外するかも確認します。
12.5 文書が古くなった場合はどうしますか?
文書の責任部署、更新日、有効期限を管理し、旧版を検索対象から外せる仕組みが必要です。RAGは一度構築して終わりではなく、知識更新の運用によって品質を維持します。
新しい情報を追加する機能だけでなく、古い情報を確実に無効化する手順まで設計することが長期運用では重要です。
12.6 利用料が想定以上に増えるのをどう防ぎますか?
モデルの使い分け、一時保存、一括処理、検索改善などを組み合わせます。さらにエージェント単位、部署単位、案件単位で費用を見える化し、増加傾向を早期に把握できる状態にします。
費用だけを下げるのではなく、再質問率や回答時間も一緒に見る必要があります。安い構成へ変更した結果、利用者の手間が増えていないかを確認するためです。
12.7 導入しても社員に使われなかった場合はどうしますか?
全社導入から始めるのではなく、実際に困っている業務で検証を行い、利用率と有用性を確認します。現場で価値が確認できた範囲だけを広げることで、使われない仕組みへ大きな投資をするリスクを抑えられます。
利用率が低い場合は、AIの性能だけでなく、利用場所、対象業務、回答の信頼性、既存手順との重複も確認します。日常的に開く業務ツールへ組み込むことも定着には重要です。
まとめ
社内RAG・AIエージェントの費用は、生成AIのモデル料金だけでは決まりません。実際には、どの文書を対象にするか、誰がどこまで閲覧できるか、検索結果をどのように評価するか、知識を誰が更新するか、どの業務システムと接続するかによって必要な開発量が変わります。そのため、価格だけを比較するのではなく、「その金額でどこまで安全に業務へ組み込めるのか」を確認することが重要です。
費用を抑えながら導入の確度を上げるには、最初から全社展開を目指すのではなく、利用者と対象文書を絞った第0段階から始める方法が現実的です。そこで検索品質、回答の有用性、利用時間の短縮、権限の安全性、一回あたりの費用を測り、本番へ進む根拠が得られたら第1段階で運用を整えます。さらに価値が確認できた領域だけを第2段階で既存システムとの連携やレビュー支援へ広げれば、効果を確認しながら投資範囲を拡大できます。
SYPの7層構成は、この段階的な導入を検索機能だけで終わらせず、利用窓口、処理の振り分け、安全な検索、回答生成、知識基盤、知識改善、統制・監視まで一つの運用基盤として捉える考え方です。社内生成AIを「試して終わる仕組み」ではなく継続して使える業務基盤にするためには、検証段階から本番運用を見据えた設計を行い、品質と費用を数字で確認しながら進めることが重要です。
「どの業務から始めるべきか」「自社文書で十分な精度が出るか」「本番までにどの程度の予算を見ればよいか」という段階でも、対象業務・データ・利用者・権限を整理することで、最初の検証範囲を明確にできます。
AIエージェント開発・検証導入について相談する※費用相場は公開情報を参考にした一般的な目安であり、SY Partnersの固定料金・標準料金を示すものではありません。